classification_visualizer
最后更新
luxonis_train.attached_modules.visualizers.classification_visualizer绘制预测的类别名称、标签类别名称和类别概率的条形图。类
ClassificationVisualizer
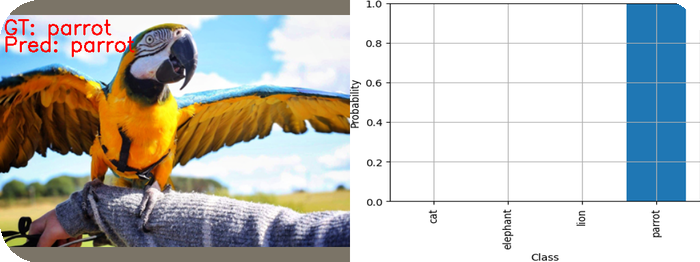
输入::prediction_canvas,target_canvas(Tensor): [B, 3, H, W]predictions(Tensor): [B, nclasses] logitstarget(Tensor | None): [B, nclasses] one-hot,或multilabel的 multi-hot
输出::Tensor | tuple[Tensor, Tensor]: [B, 3, H, W],当设置include_plot时带有概率图
参考
- 来源:本项目。
- 许可证:Apache-2.0(本项目)
注意事项
使用 OpenCV 渲染预测和目标类别名称,并可添加 Matplotlib 概率条形图。
示例
附加到
model.nodes 中的 ClassificationHead:Yaml
1- name: ClassificationHead
2  inputs: [ResNet]
3  visualizers:
4 - name: ClassificationVisualizer方法
init
Python
1def __init__(include_plot: bool = True, font_scale: float | None = None, color: tuple[int, int, int] = (255, 0, 0), thickness: int = 2, multilabel: bool = False, **kwargs):include_plot(bool): forward 是否也返回类别概率的条形图作为第二张图像。默认为True。font_scale(float | None): OpenCV 文本的字体比例。当为None时,dynamically_determine_font_scale 从图像大小推导出比例。文本行位于图像高度的 15% 和 25% 处。值为0时选择相同的行位置,但保持字体比例为0并将厚度设置为1。任何其他值按给定应用,与thickness一起,并将文本行放置在y = 50和y = 75像素处。color(tuple[int, int, int]): 文本的 RGB 颜色。默认为(255, 0, 0),红色。thickness(int): 文本描边的厚度。当推导出的字体比例小于1时,厚度变为1。默认为2。multilabel(bool): 任务是否为多标签。当为True时,文本列出每个原始值大于0.5的类别,图表显示 sigmoid 概率。当为False时,文本显示值最高的类别,图表显示 softmax 概率。默认为False。**kwargs: 转发给 BaseVisualizer 的关键字参数,例如scale和node。
forward
Python
1def forward(prediction_canvas: Tensor, target_canvas: Tensor, predictions: Tensor, target: Tensor | None) -> Tensor | tuple[Tensor, Tensor]:Pred: <name>。当给定 target 时,它在其上方写入 GT: <name>。两行都使用 color 以及 font_scale 选择的字体比例和厚度。当 include_plot 为 True 时,它还会渲染一个类别概率的条形图,其大小与预测画布相同。参数prediction_canvas(Tensor): 形状为[B, 3, H, W]的图像。该方法仅读取其形状、dtype 和设备,用于绘图。target_canvas(Tensor): 形状为[B, 3, H, W]的图像,用于写入文本。predictions(Tensor): 形状为[B, n_classes]的 logits。target(Tensor | None): 形状为[B, n_classes]的 one-hot 标签,或multilabel的 multi-hot。当批次没有classification标签时为None;此时该方法不写入GT行。
Tensor | tuple[Tensor, Tensor]: 当include_plot为True时,返回(text_images, plots)对,两者形状均为[B, 3, H, W]。否则只返回文本图像。