DataDreamer®
最后更新
快速入门
- 使用生成式 AI 和基础视觉模型从头开始生成合成数据集。
- 预标注现有图像数据集,以减少审查和训练前的手动标注工作。
Command Line
1pip install datadreamer
2datadreamer --class_names person moon robot- Google Colab 笔记本,包含如何生成数据集、训练模型并将其导出到 RVC2/RVC3 的说明:DataDreamer 快速入门
- 头盔检测示例:头盔检测
- 实例分割示例:实例分割
概述
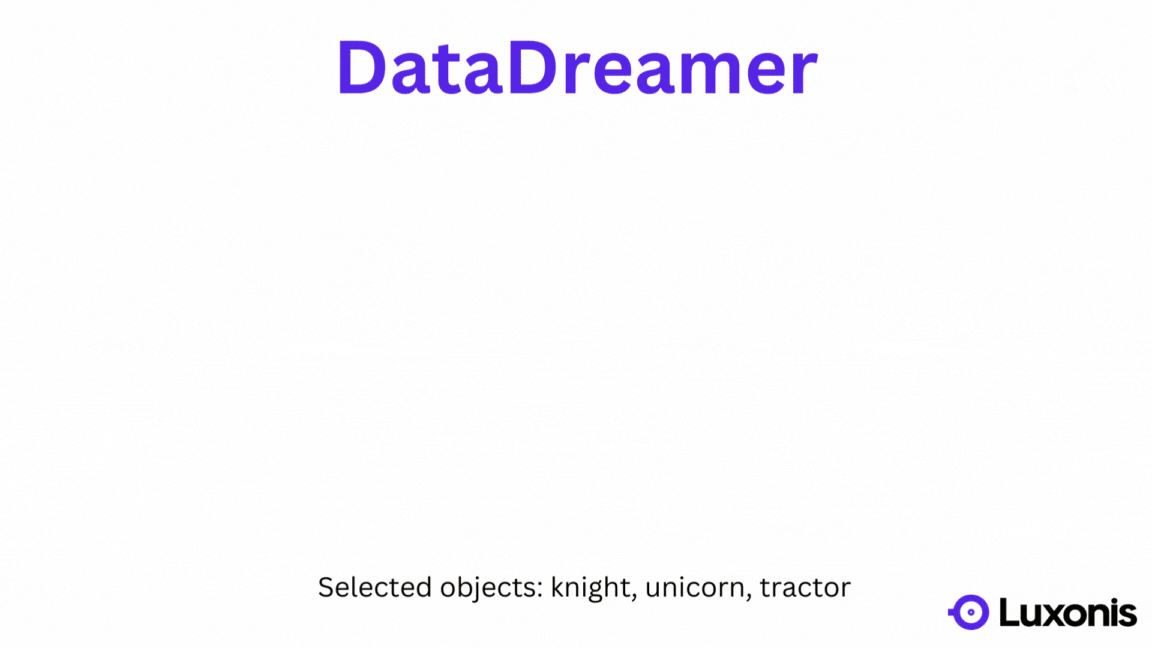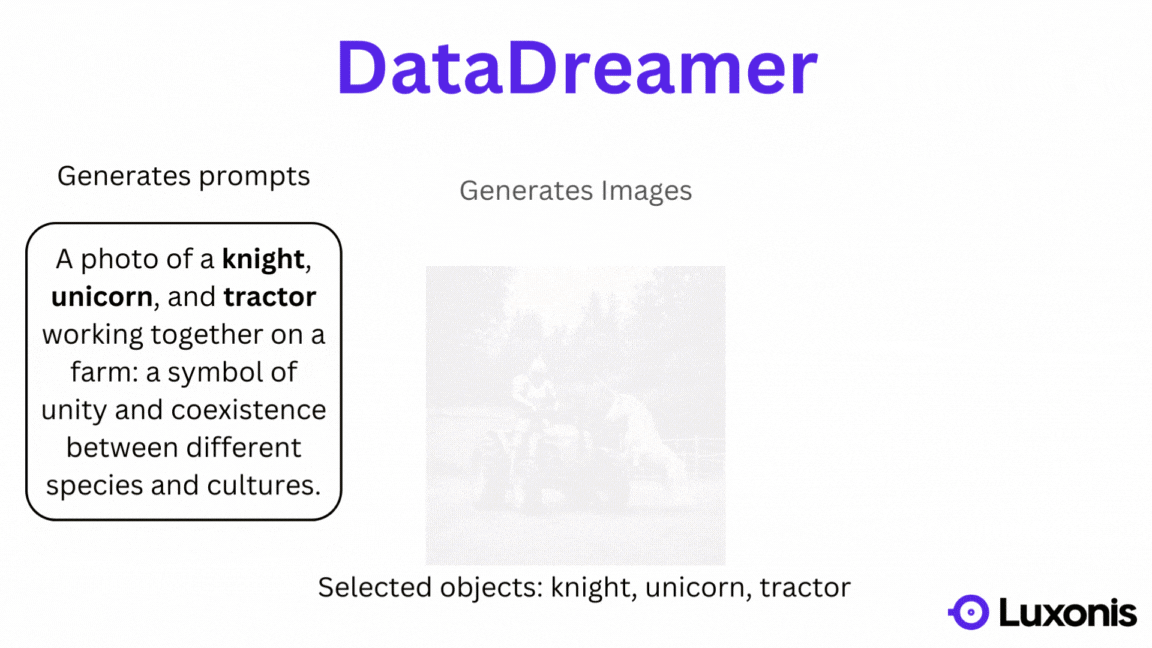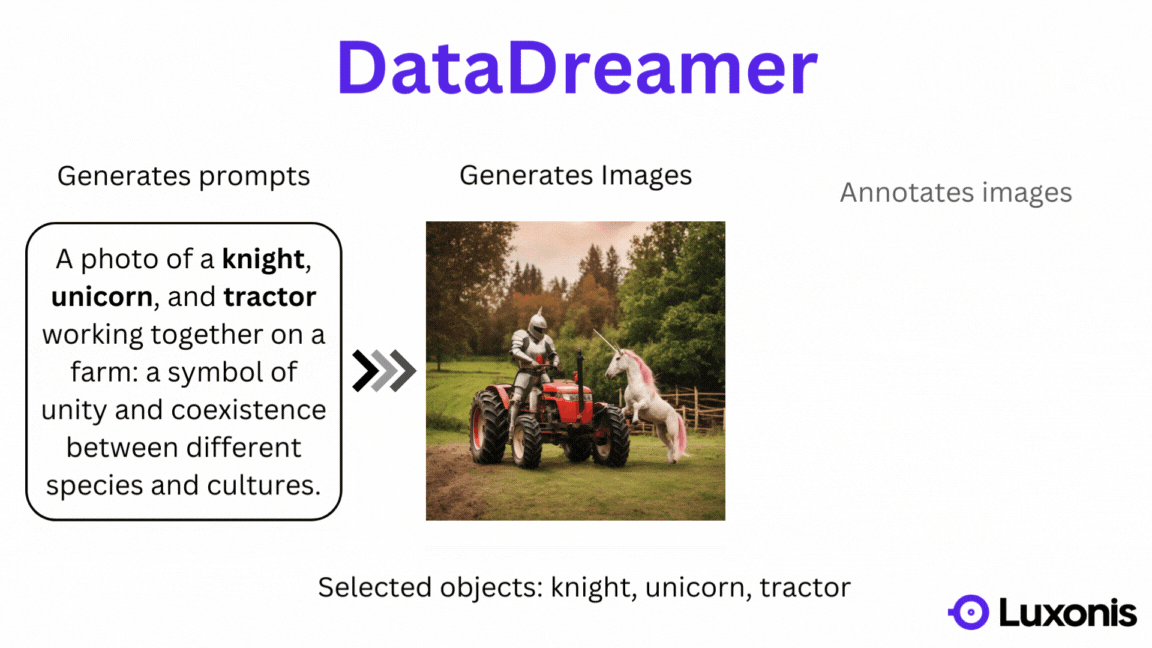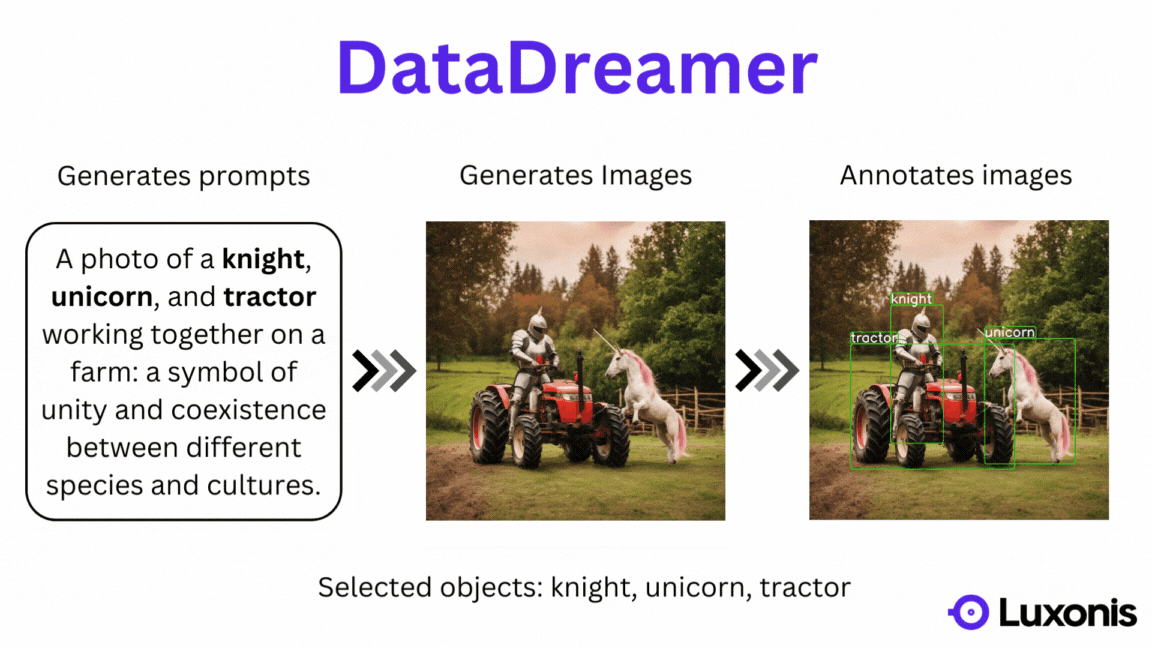
DataDreamer 是一个先进的工具包,旨在促进边缘 AI 模型的开发,无论初始数据可用性如何。DataDreamer 的独特功能包括:- 合成数据生成:消除对大量数据集进行 AI 训练的依赖。DataDreamer 允许用户从头开始生成合成数据集,利用先进的 AI 算法生成高质量、多样化的图像。
- 真实数据预标注:对您已有的图像使用相同的标注管道,以引导分类、对象检测和实例分割任务的标签。
- 从基础模型中提取知识:
DataDreamer利用复杂、预训练的 AI 模型中嵌入的潜在知识。此功能允许将这些“基础模型”的广泛理解转移到更小、自定义构建的模型中,从而显著增强其功能。 - 高效且强大的模型:
DataDreamer的主要目标是创建紧凑的模型,这些模型既能高效地集成到任何设备中,又能在专业任务中表现出色。
功能
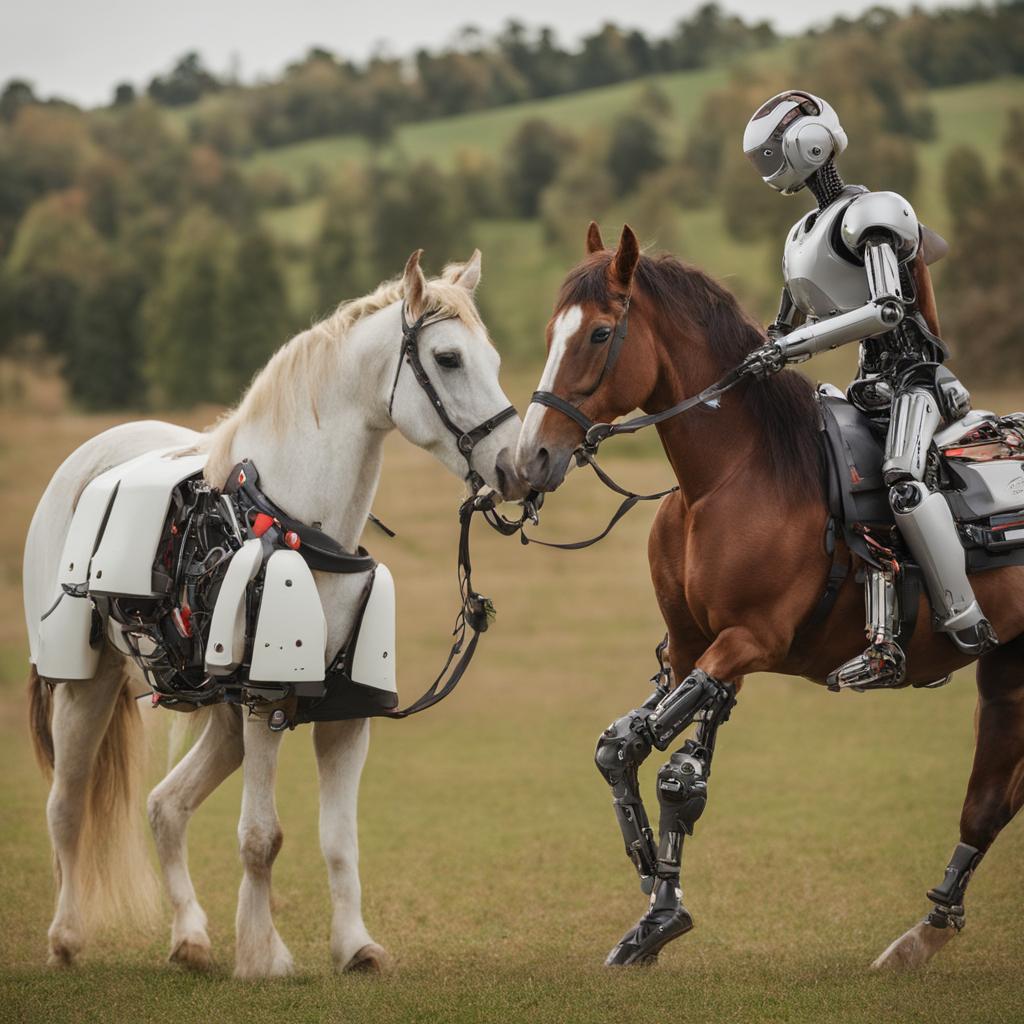
- 提示生成:使用强大的语言模型自动创建图像提示。提供的类名:["horse", "robot"]生成的提示:“一匹马和一个机器人在宁静的牧场中和平共处的照片。”
- 图像生成:使用最先进的生成模型生成合成数据集。
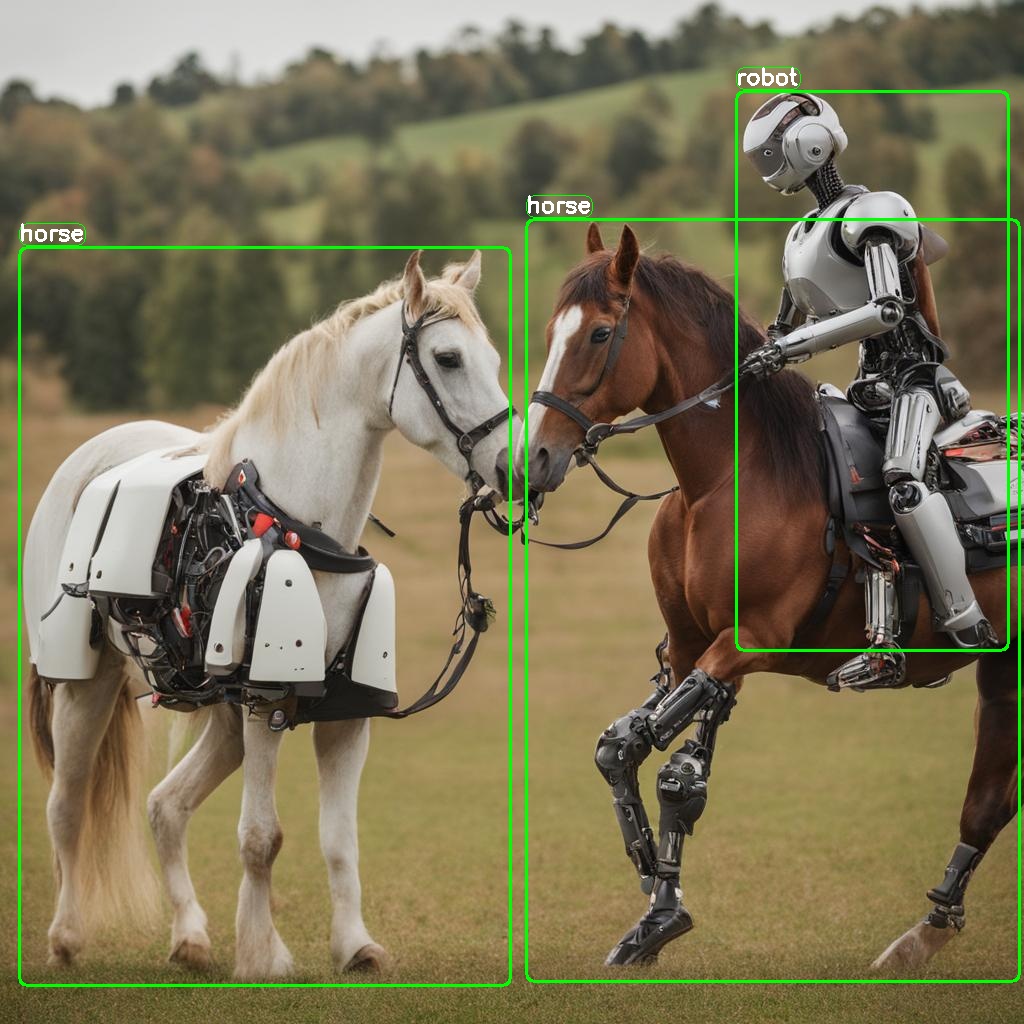
- 数据集标注:利用基础模型自动标注数据集。
- 预标注现有数据:当您希望在手动 QA 之前进行初始标签处理时,在真实图像目录上运行 DataDreamer。
- 边缘模型训练:训练用于边缘部署的高效小型神经网络。(不属于此库)
预标注现有数据集
Command Line
1datadreamer \
2  --task instance-segmentation \
3  --image_annotator owlv2-slimsam \
4  --save_dir dataset_path \
5  --class_names dumpling \
6  --annotate_only
--annotate_only 禁用提示生成和图像生成,因此 DataDreamer 只运行标注阶段。将其与 --task 和 --image_annotator 结合使用,可在分类、检测和实例分割工作流程之间切换。安装
Command Line
1pip install datadreamerCommand Line
1docker pull ghcr.io/luxonis/datadreamer:latest
2docker run --rm -v "$(pwd):/app" ghcr.io/luxonis/datadreamer:latest --save_dir generated_dataset --device cpu--gpus all 与 --device cuda 一起使用。硬件要求
- 建议使用至少 16 GB 内存的 CUDA 兼容 GPU,以获得最佳体验。
- 建议至少 16 GB 系统 RAM,对于大型作业,最好是 32 GB 或更多。
可用模型
| 模型类别 | 模型名称 | 描述/备注 |
|---|---|---|
| 提示生成 | Mistral-7B-Instruct-v0.1 | 语义丰富的提示 |
| TinyLlama-1.1B-Chat-v1.0 | 小型语言模型 | |
| Qwen2.5-1.5B-Instruct | Qwen2.5 语言模型 | |
| 简单随机生成器 | 连接随机选择的对象名称 | |
| 脏话过滤器 | Qwen2.5-1.5B-Instruct | 快速准确的语言模型脏话过滤器 |
| 图像生成 | SDXL-1.0 | 慢速且准确(1024x1024 图像) |
| SDXL-Turbo | 快速且不那么准确(512x512 图像) | |
| SDXL-Lightning | 快速且准确(1024x1024 图像) | |
| Shuttle-3-Diffusion | 快速且准确(512x512 图像) | |
| 图像标注 | OWLv2 | 开放词汇对象检测器 |
| CLIP | 零样本图像分类 | |
| AIMv2 | 零样本图像分类 | |
| SlimSAM | 零样本实例分割 | |
| SAM2.1 | 零样本实例分割 |
用法
Command Line
1datadreamer --save_dir path/to/save_directory --config configs/det_config.yaml--task用于选择detection、classification或instance-segmentation--dataset_format用于选择raw、yolo、coco、voc、luxonis-dataset或cls-single--image_annotator用于选择检测器、分类器或分割堆栈--device用于选择cuda或cpu
prompts.json 和 annotations.json 一起写入。其他输出格式旨在直接插入常见的训练管道。示例
Command Line
1datadreamer --save_dir path/to/save_directory --class_names person moon robot --prompts_number 20 --prompt_generator simple --num_objects_range 1 3 --image_generator sdxl-turbo有用提示
- 批量生成:当内存允许时,增加
--batch_size_prompt、--batch_size_image和--batch_size_annotation以提高吞吐量。 - 更好的图像质量:当质量比速度更重要时,优先选择
sdxl-lightning、shuttle-3或sdxl而不是sdxl-turbo。 - 图像选择:当您希望 DataDreamer 花更多时间选择更好的生成时,请将
--use_image_tester与--image_tester_patience一起使用。 - 每张图像的对象数量:保持
--num_objects_range适中。对于当前的图像生成器来说,超过 3 的值通常更难可靠地渲染。 - 提示生成:当您想要比简单随机生成器更多样化的提示时,请使用
--prompt_generator tiny、lm或qwen2。