数据集健康状况、拆分和版本
最后更新
概述
健康状况和拆分大小统计注释状态为已完成的样本。在使用这些指标判断准备情况之前,请审查并完成已批准的样本。
审查数据集元数据和健康状况
打开“元数据”选项卡
打开数据集并选择元数据。摘要显示已完成的总大小、每个拆分中已完成的样本以及未完成的样本数量。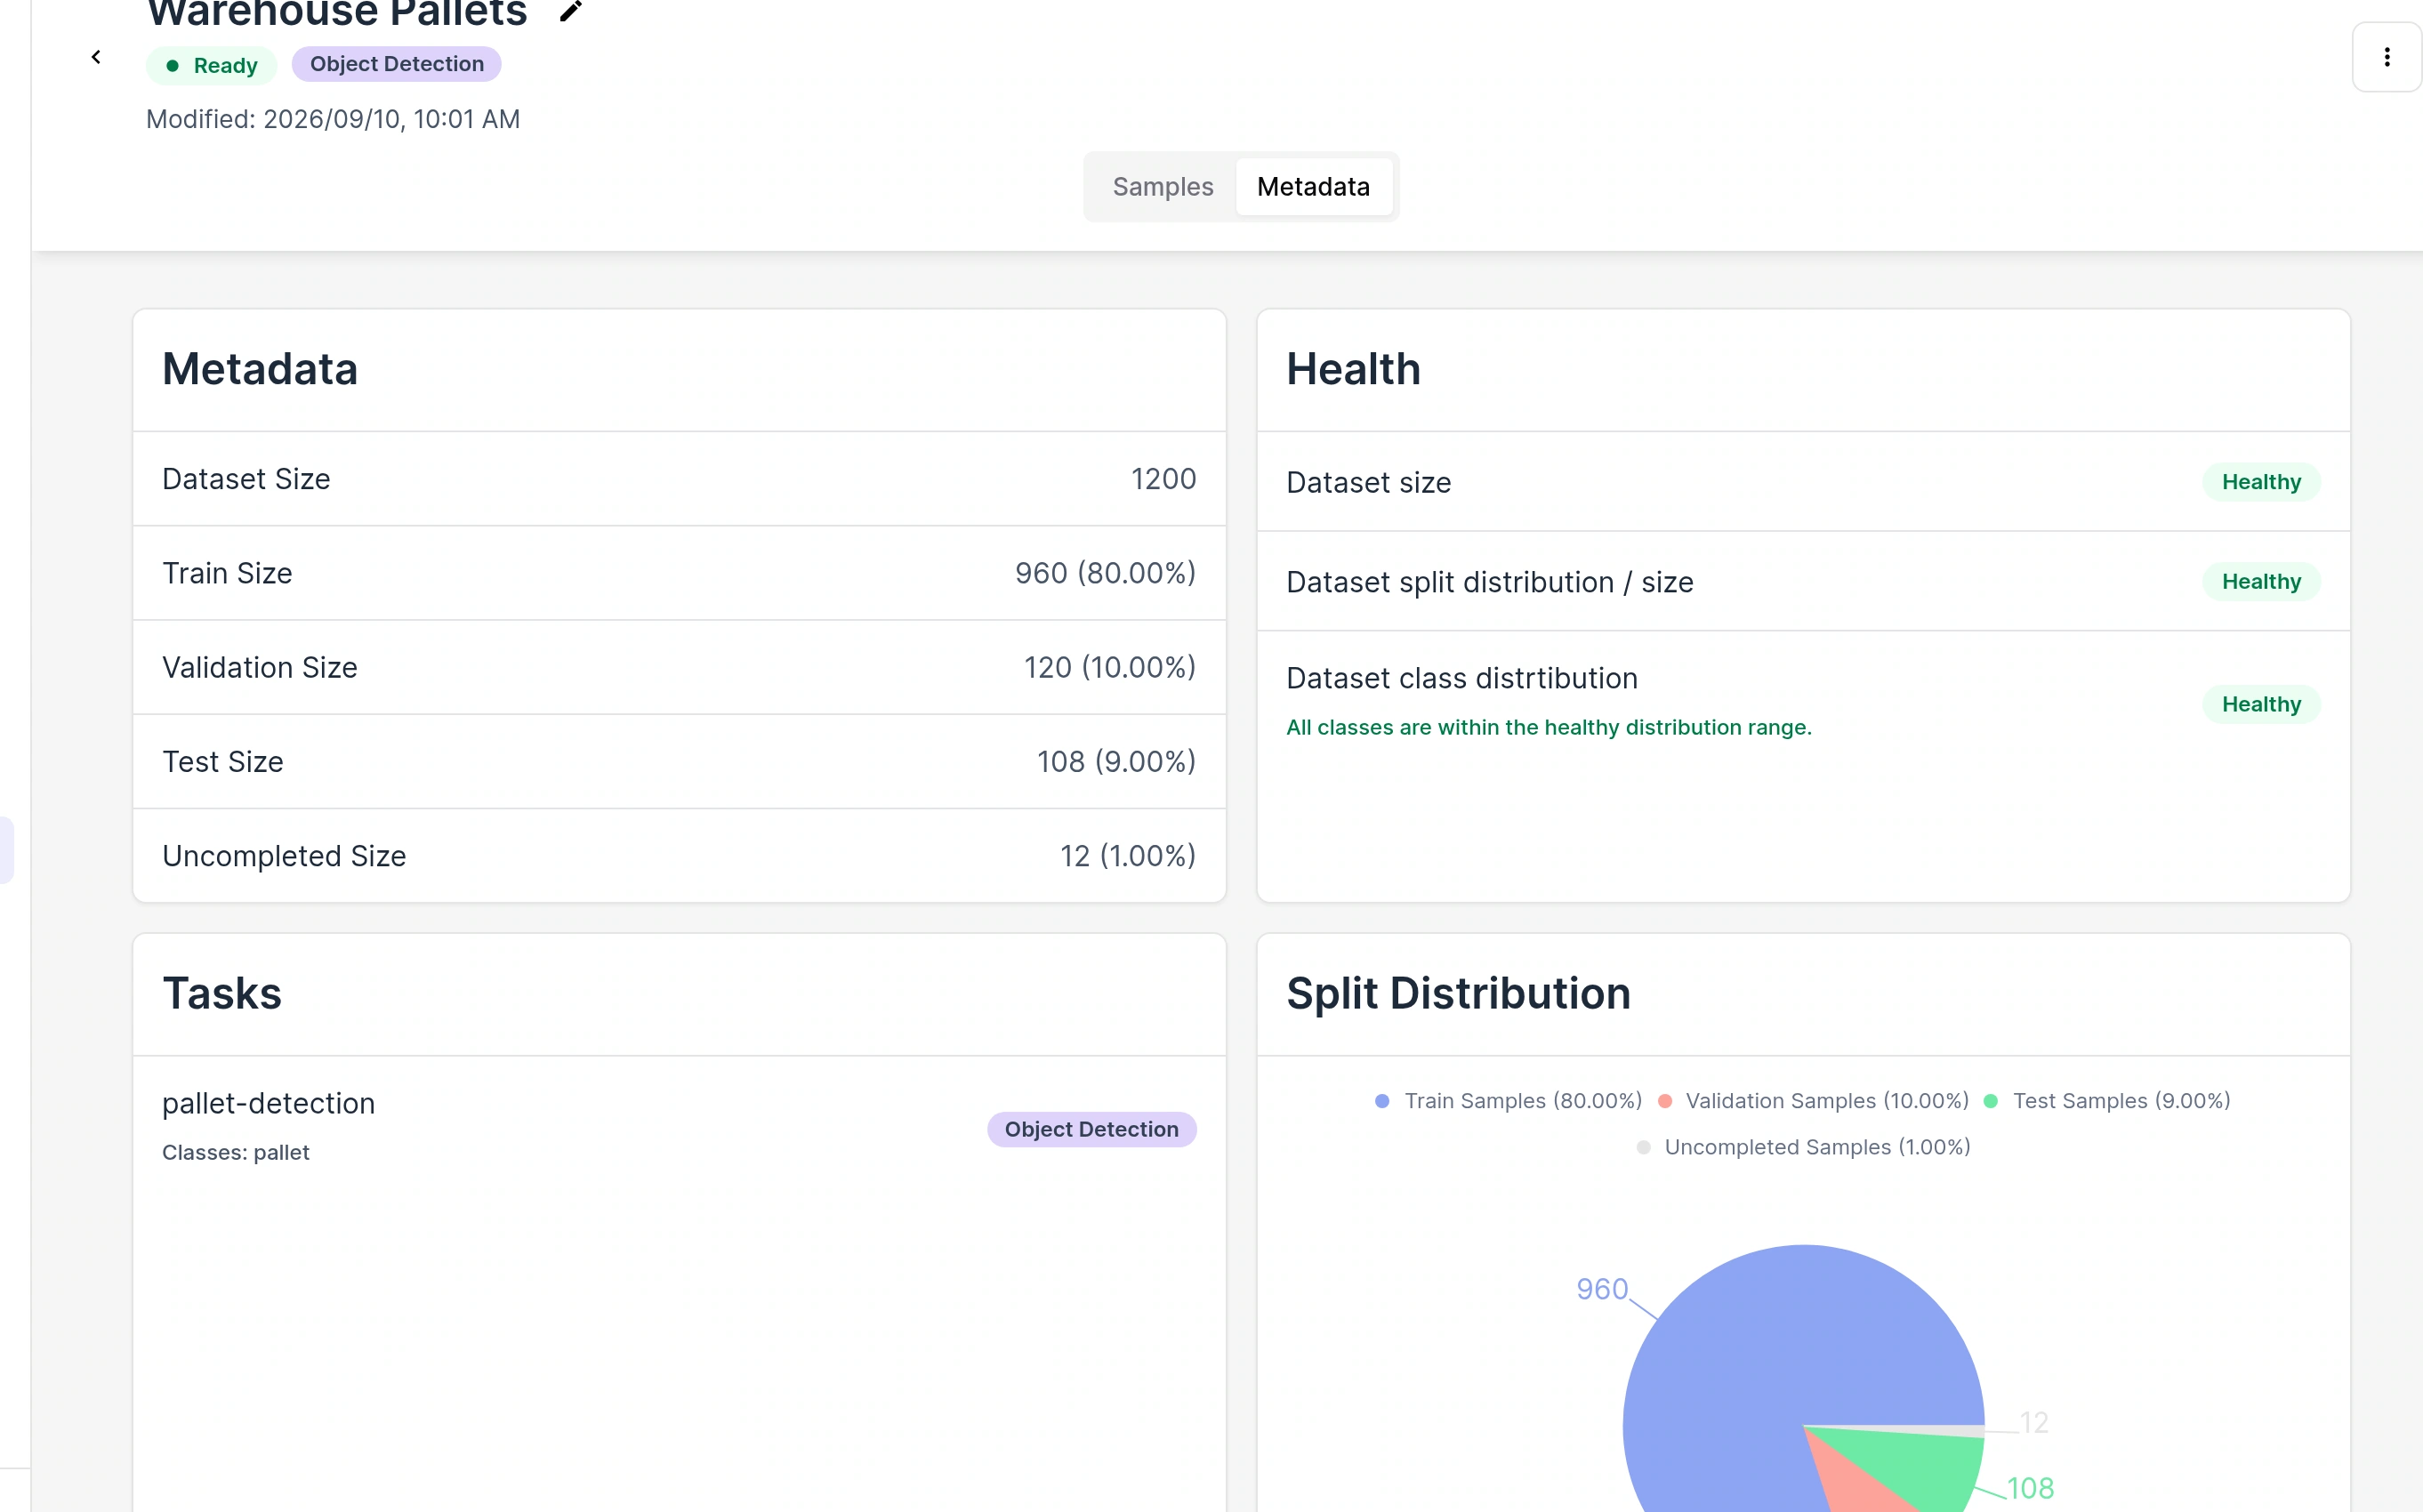
检查健康检查和分布
审查整体健康状态和每个健康行。页面还列出了任务名称、任务类型和类别、拆分分布图以及每个类别的注释计数。使用这些详细信息来决定是否收集更多数据、完成更多注释、调整拆分或解决类别不平衡问题。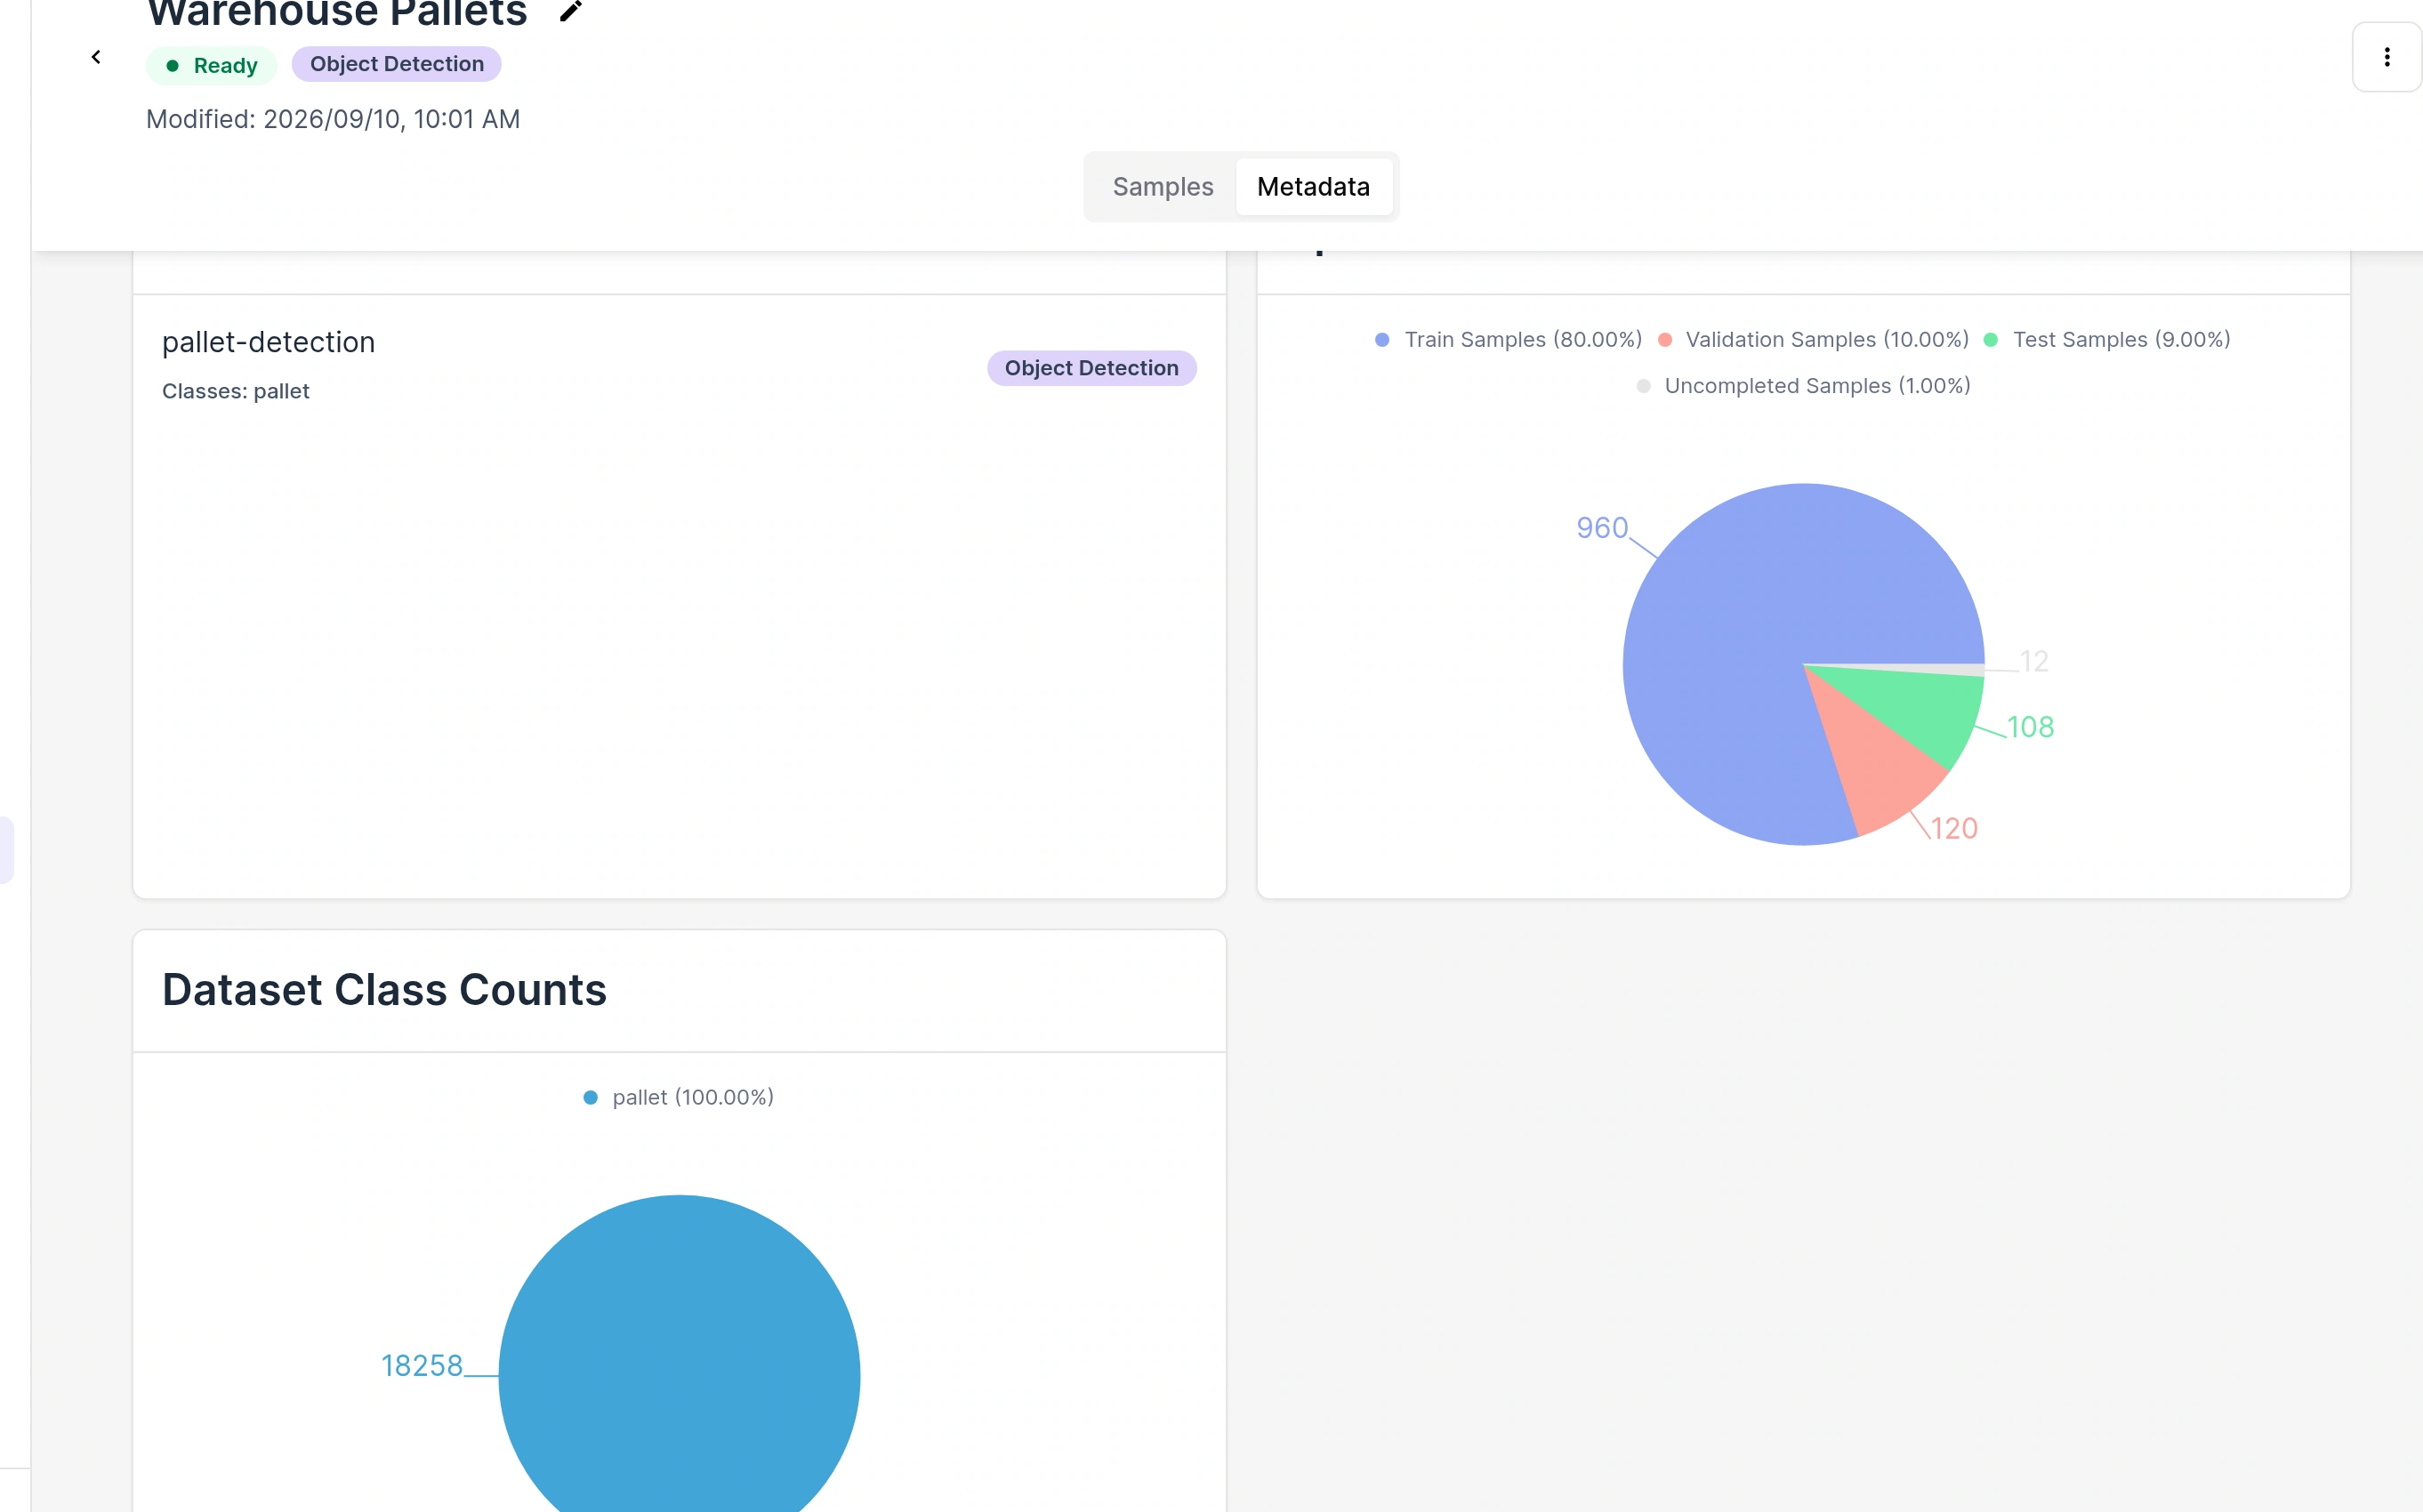
健康检查参考
| 检查 | 健康信号 | 不健康或失败信号 | 重要性 |
|---|---|---|---|
| 大小 | 至少 1,000 个已完成样本 | 少于 16 个失败;16-999 个不健康 | 非常小的数据集难以学习泛化模式 |
| 拆分分布 | 已完成样本在训练、验证和测试中大致按 80/10/10 分布 | 一个或多个拆分与其预期份额存在显著差异 | 训练需要大部分数据,而验证和测试需要足够的独立示例才能有意义 |
| 类别分布 | 每个类别都有代表,并且没有一个类别远低于平均份额 | 某个类别缺失或严重不足 | 严重不平衡会使模型偏向频繁出现的类别 |
健康状况是建议性的
健康状态不能保证模型质量,不健康状态本身也不会阻止运行。训练确实需要至少一个已完成的训练样本。如果验证为空,训练工作流将回退到训练拆分。评估运行需要您选择的验证或测试拆分中的已完成样本。
了解拆分
- 训练拆分在模型权重更新期间反复出现。
- 验证拆分在训练期间进行检查,以调整决策并选择最佳检查点。
- 测试拆分在做出训练选择后,用于最终、偏差较小的测量。
为训练版本化数据集
启用“版本数据集”并选择可选标签
从项目中,打开新建训练运行并启用版本数据集。版本使用运行名称,因此数据快照很容易与其运行关联。当运行只需要数据集的一部分时,选择标签。AND 要求所有选定的标签,而OR 包含具有任何选定标签的样本。将过滤器留空以版本化完整数据集。当您提交运行后,版本并开始训练运行作业将在训练开始前创建或重用版本。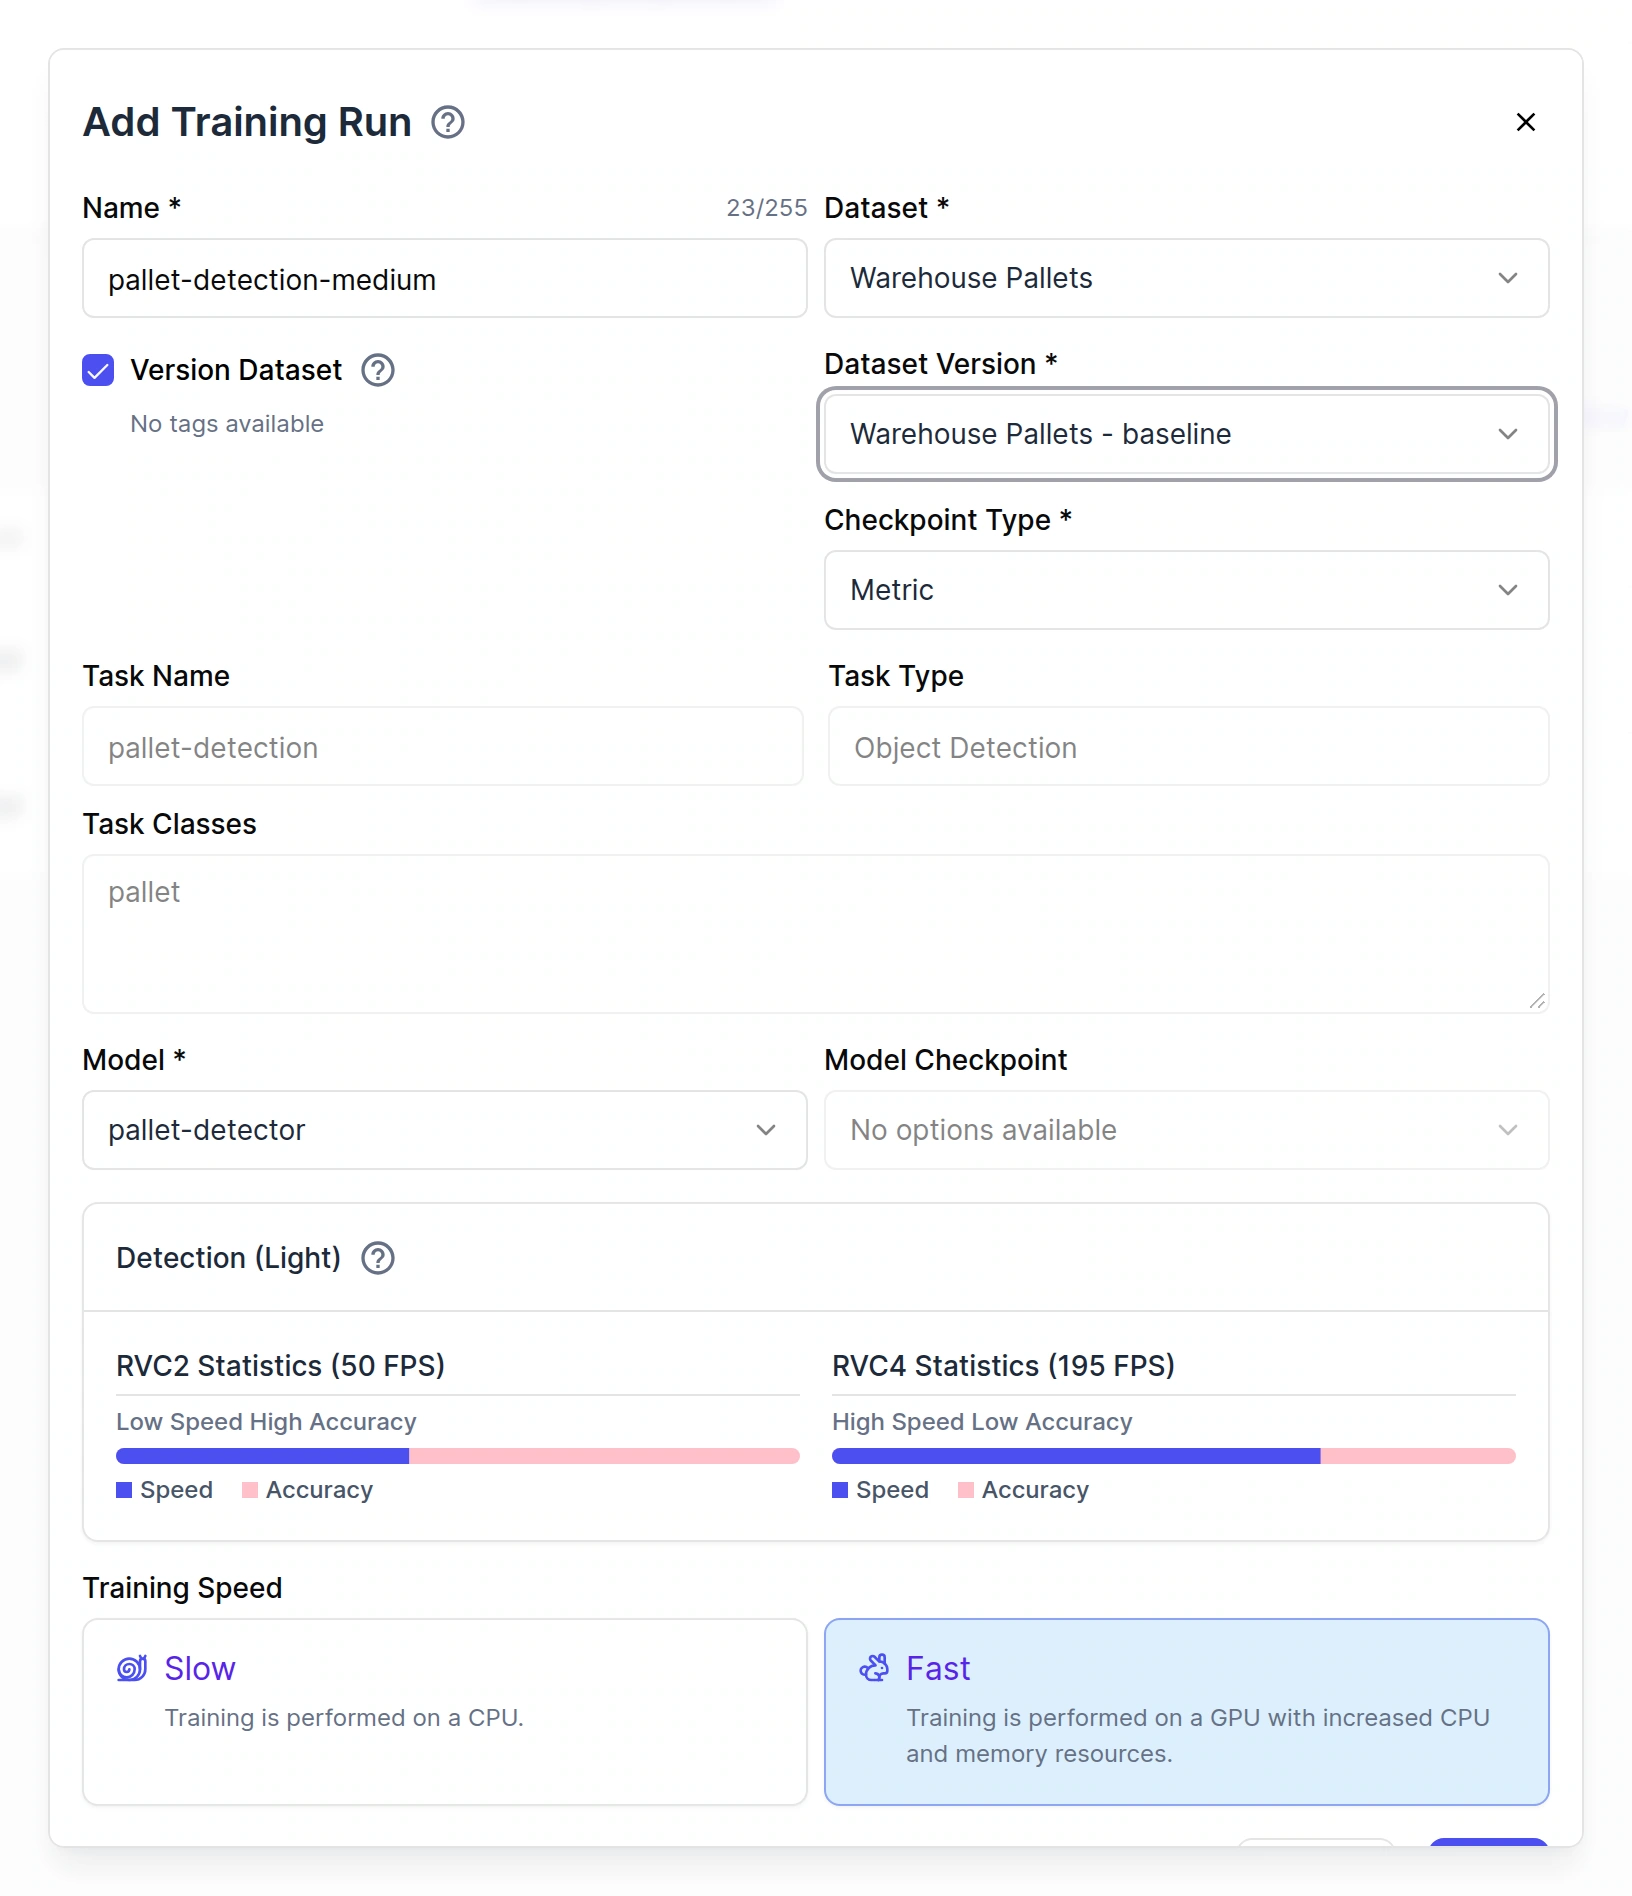
从数据集或运行中查找版本
使用数据集页面上的版本过滤器检查只读快照。数据集版本选择器和运行的链接数据集版本字段提供对同一资源的直接访问。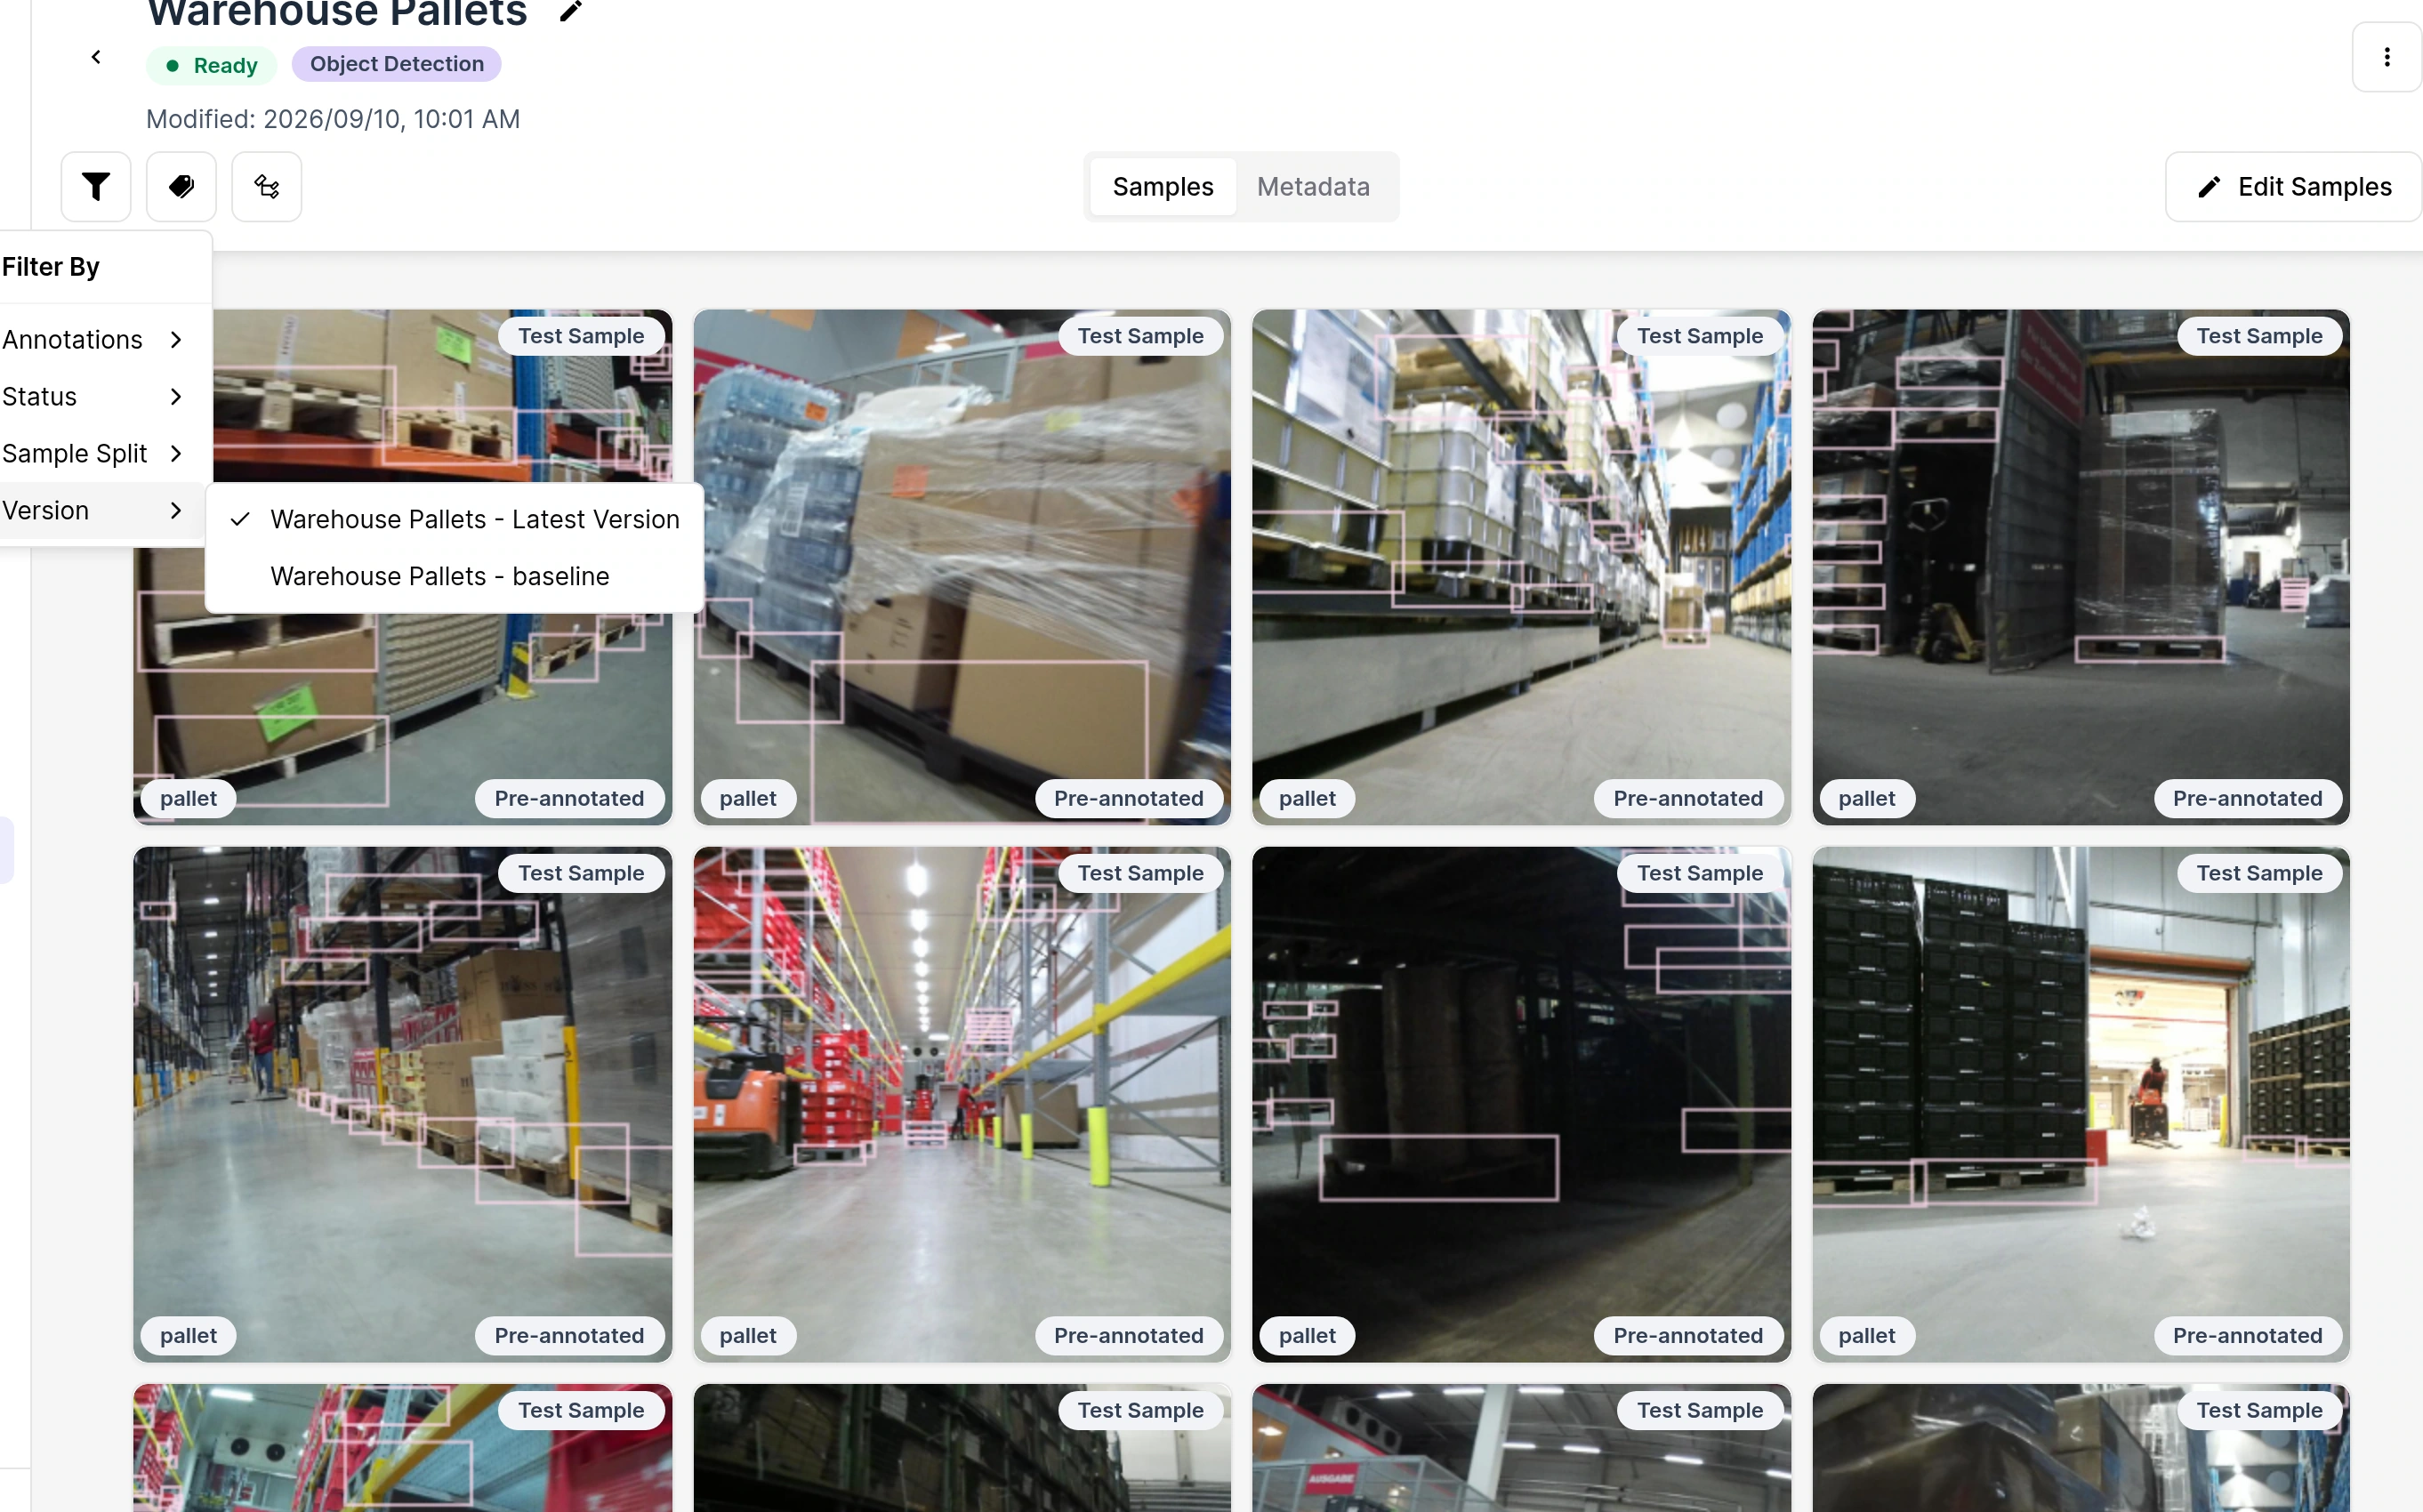
- 在工作数据集更改后重现运行;
- 在相同的样本和注释上比较架构或设置;
- 审计生成已部署模型的数据;
- 在继续收集数据时保留标签选择的训练队列。