训练和评估运行
最后更新
概述
首先准备一个包含已完成训练样本的数据集。项目任务名称和类型必须与数据集匹配,并且每个项目类必须存在于相应的数据集任务中。
创建项目
打开项目并添加项目
打开 Luxonis Hub,选择 Projects,然后点击 Add Project。输入一个描述性的项目名称。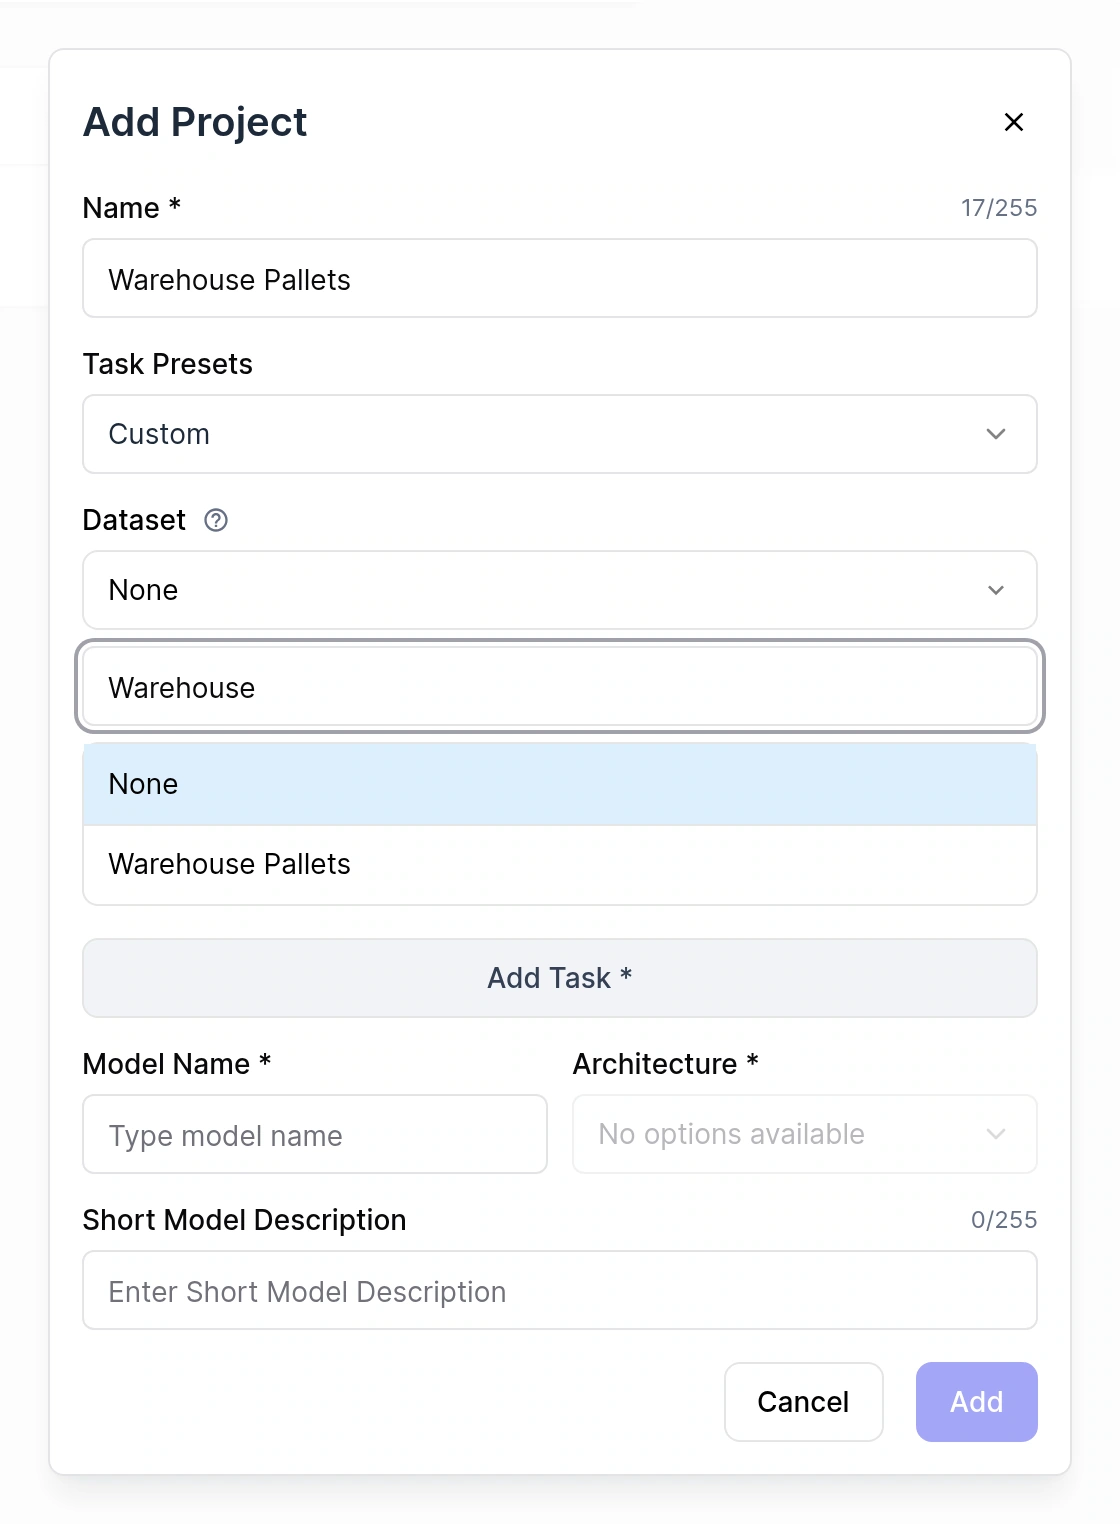
继承数据集任务
选择源 Dataset 以将其任务名称、类型和类复制到项目中。仔细审查任务定义,因为项目任务在创建后是只读的。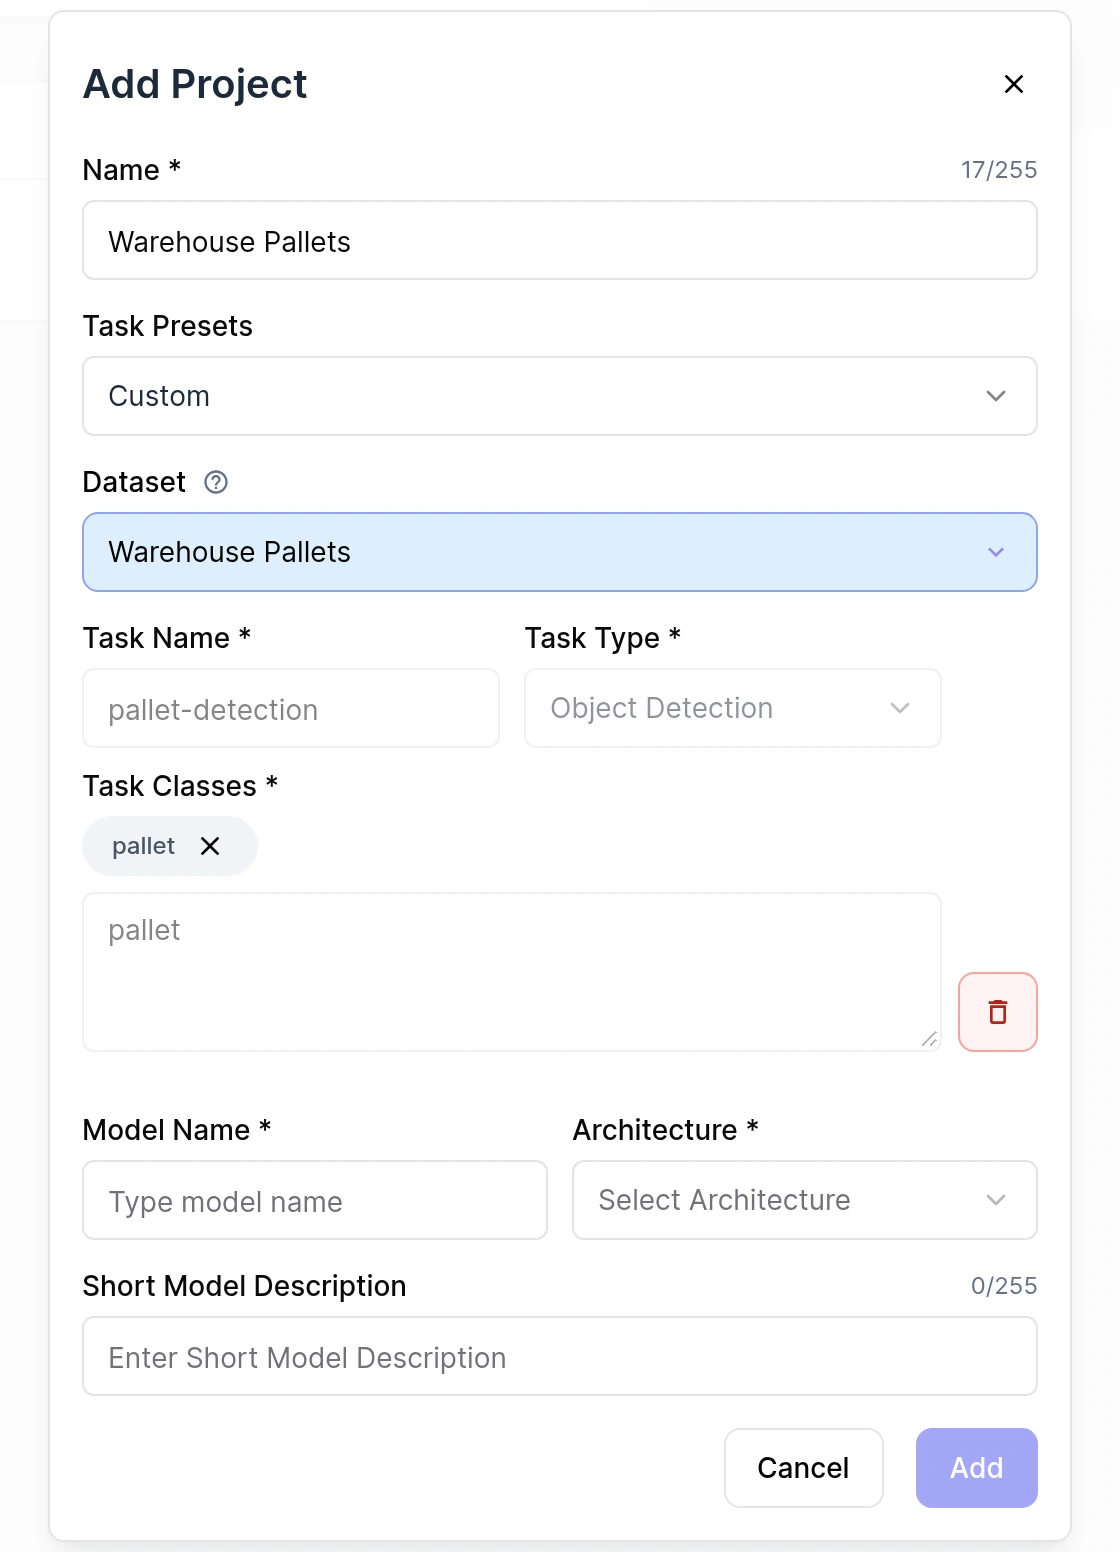
选择模型和架构
输入链接的模型名称,例如 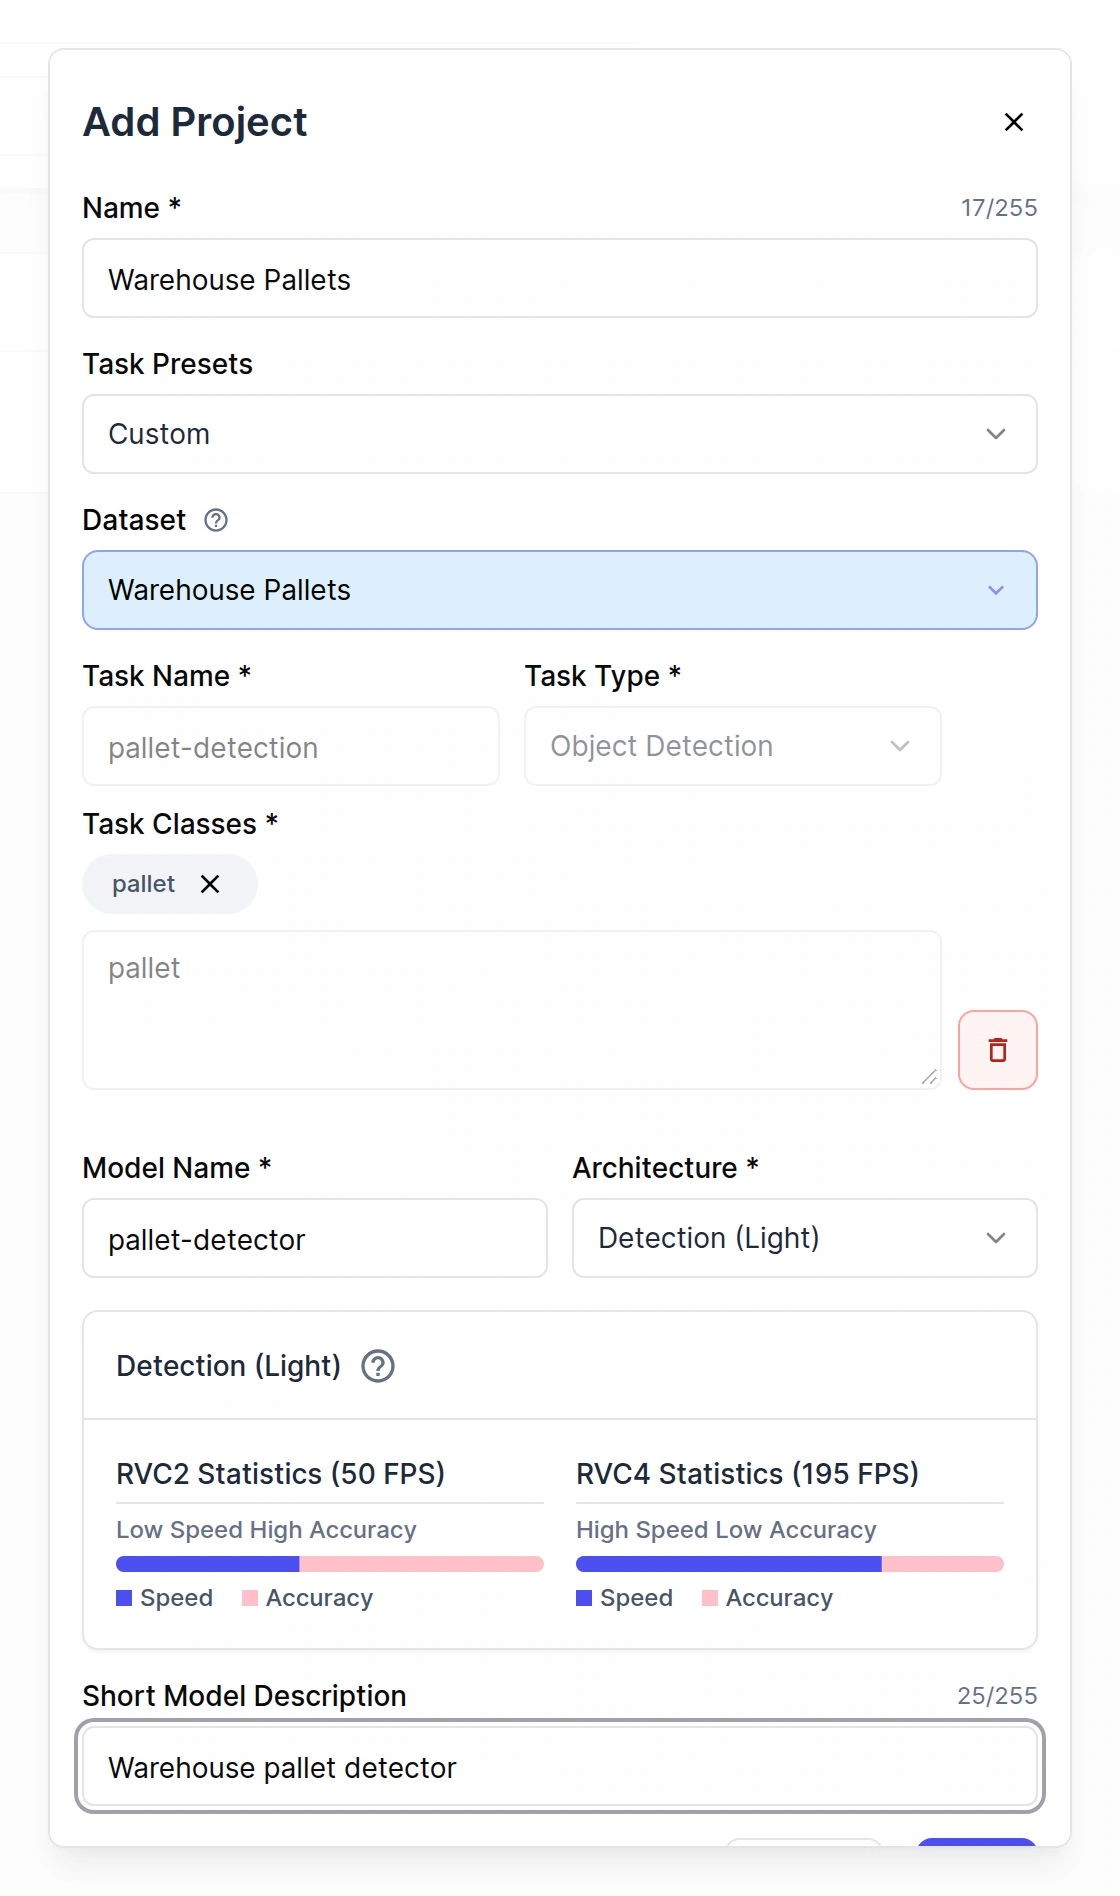
pallet-detector,然后选择一个兼容的架构,例如 Detection (Light)。审查架构卡的相对速度、准确性和支持平台统计数据,添加可选描述,然后点击 Add。项目创建会生成模型
创建项目时,会固有地创建一个新模型并以给定名称链接到该项目。这是此特定项目的所有训练模型工件的存储位置。每个项目都有一个独特的模型。
开始训练运行
打开训练运行表单
打开项目并点击 New Training Run。为运行命名,以标识其数据和实验,例如 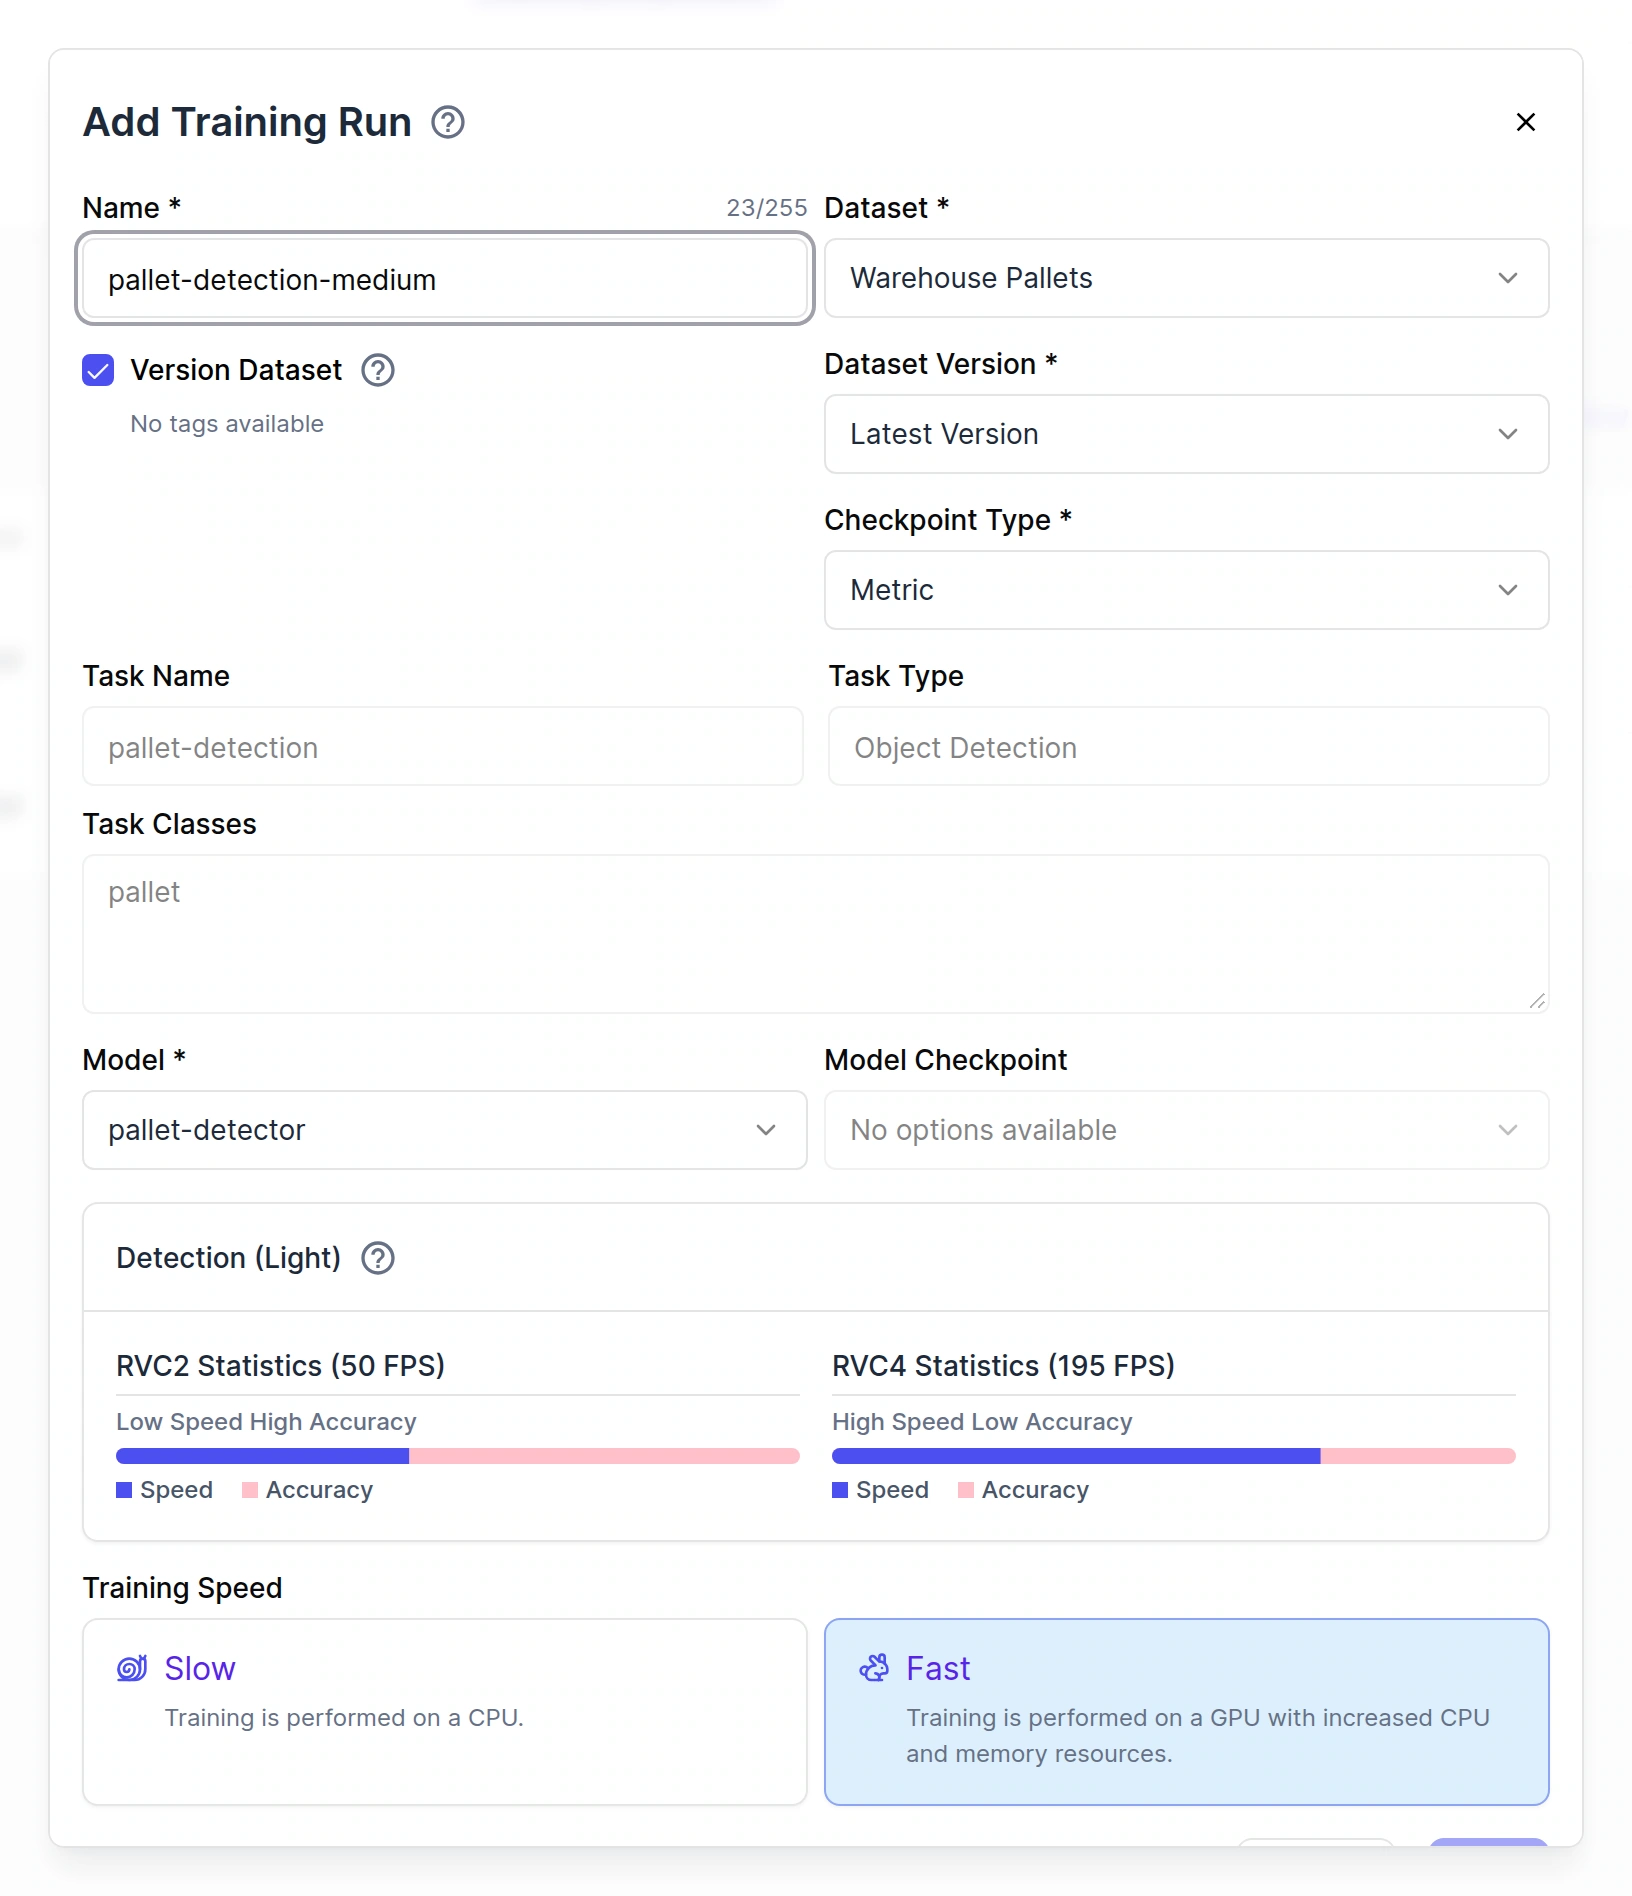
pallet-detection-medium。选择数据集输入
选择兼容的 Dataset。保持 Version Dataset 启用以创建只读快照,并可选择使用 AND 或 OR 过滤器选择标签。如果您不创建新版本,请选择现有 Dataset Version 或最新的工作数据集。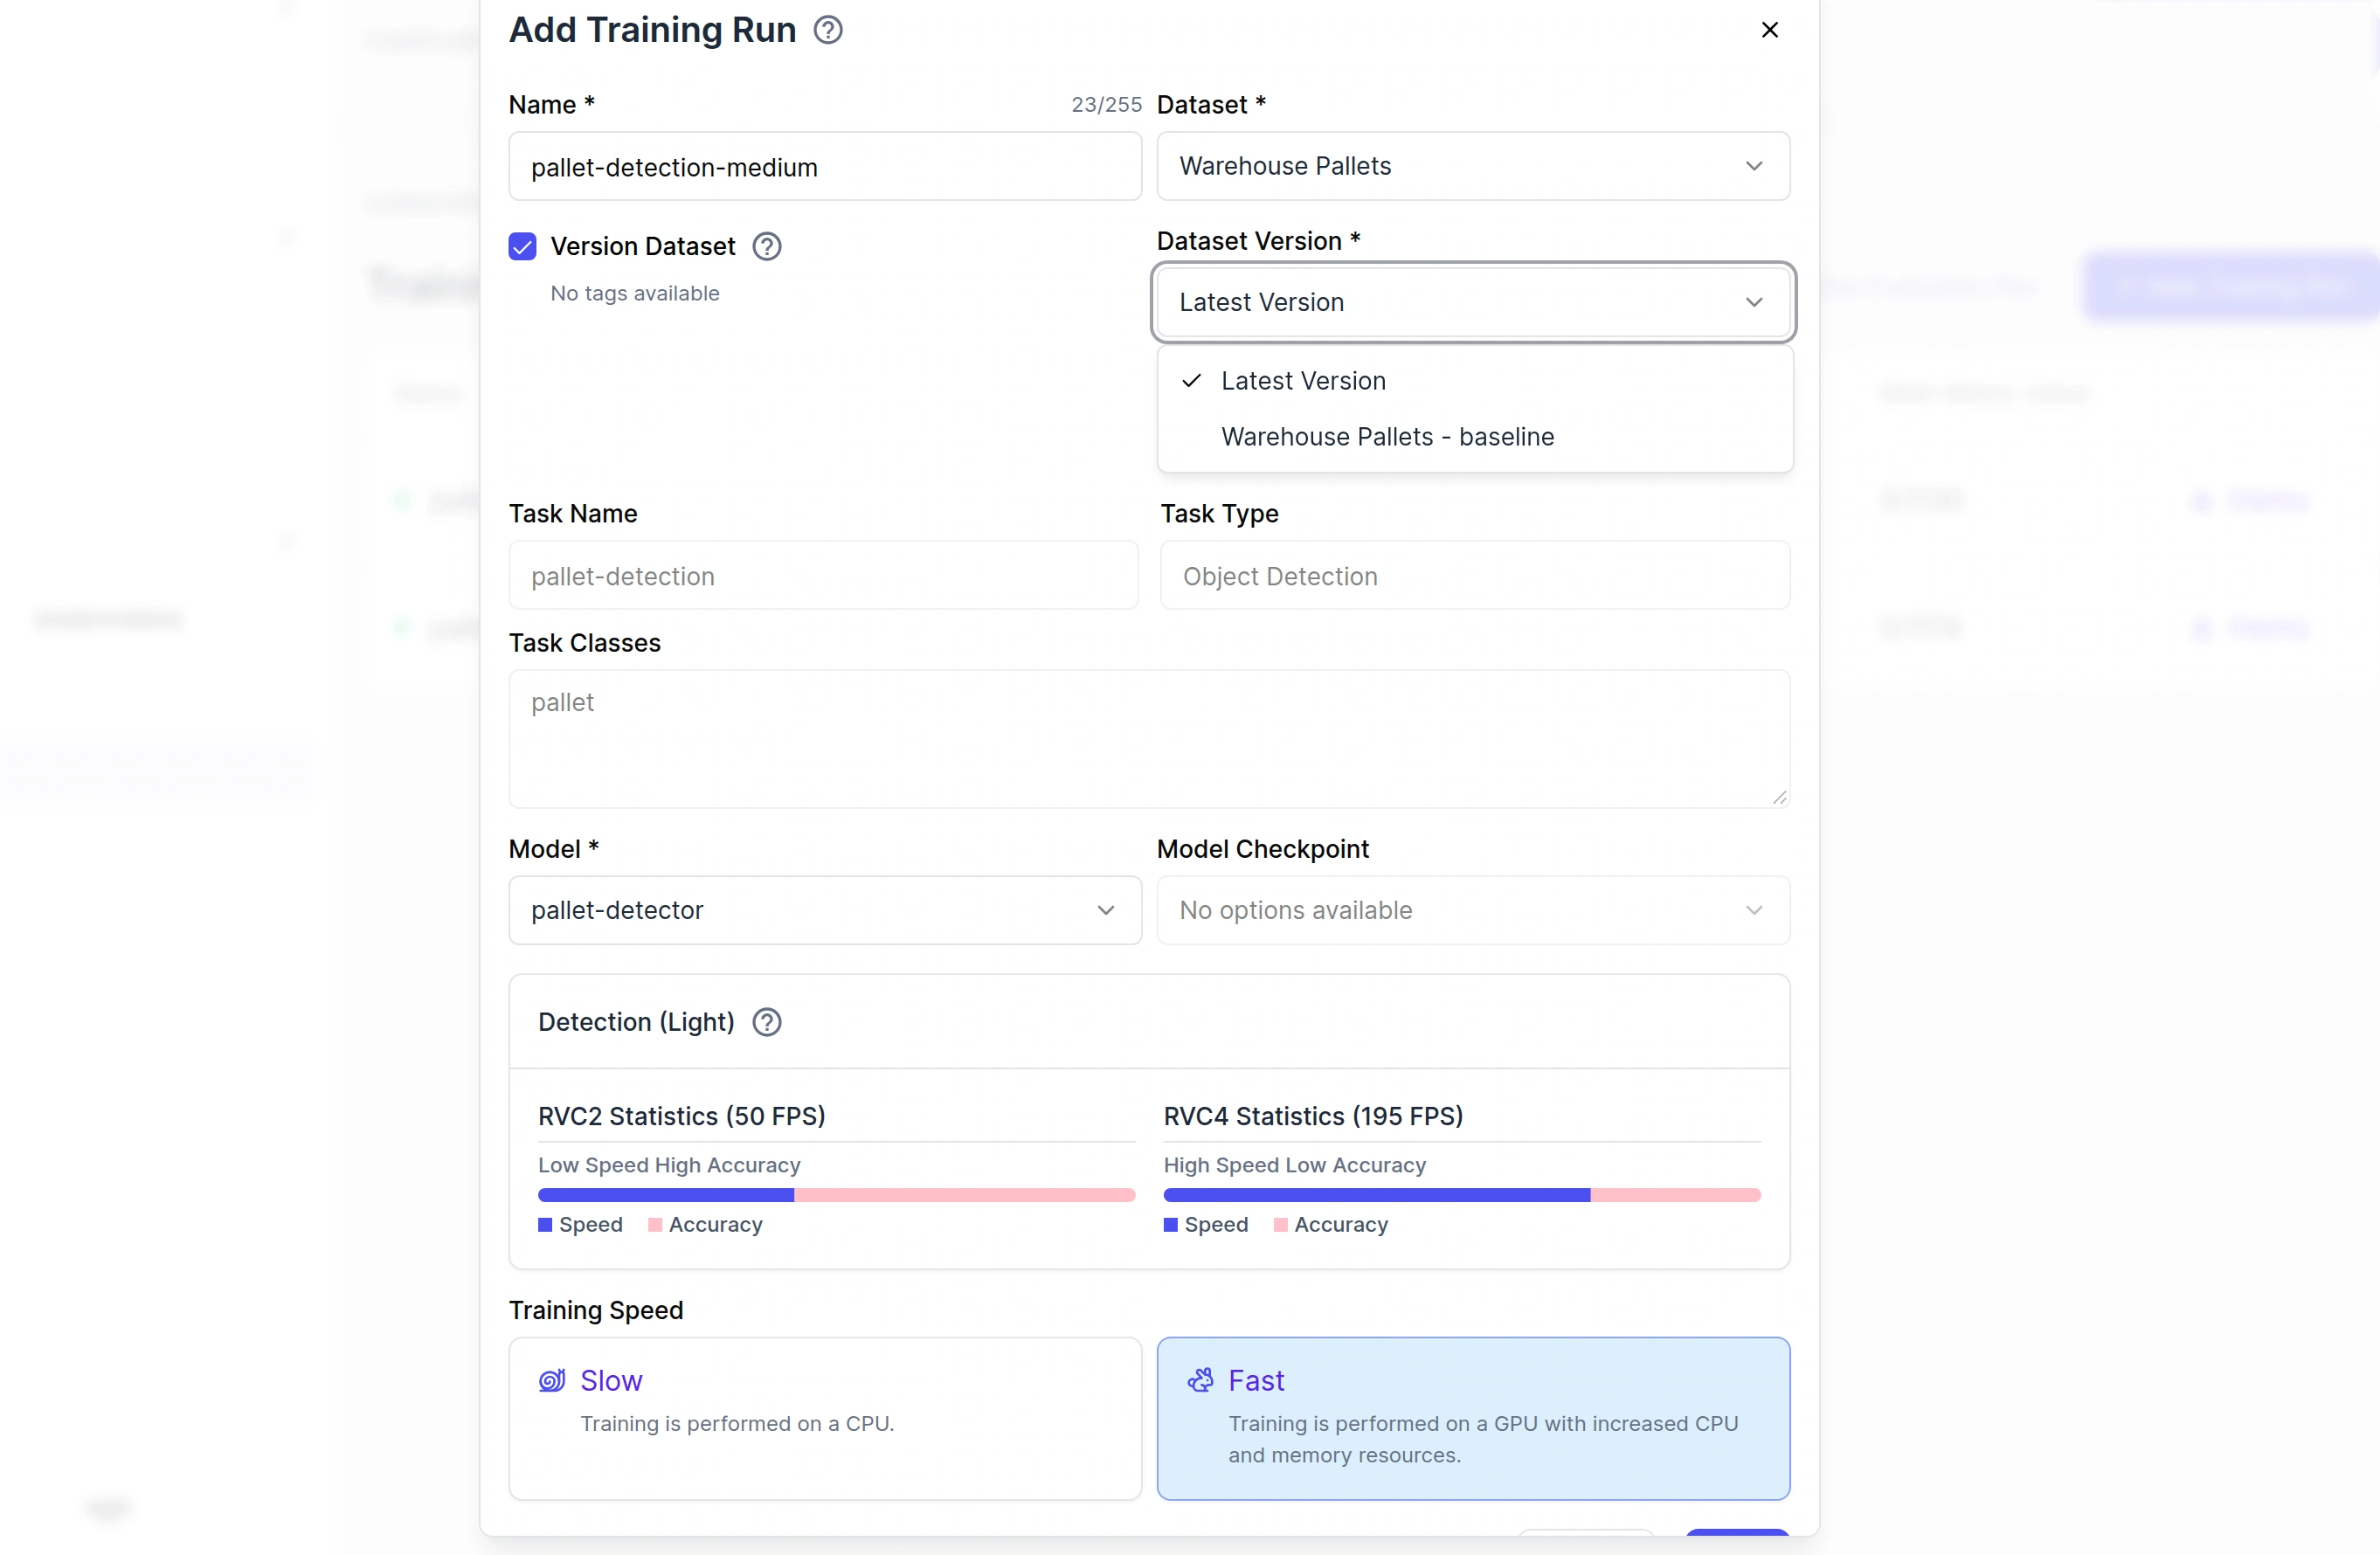
选择模型和检查点
选择链接的 Model 并选择检查点策略: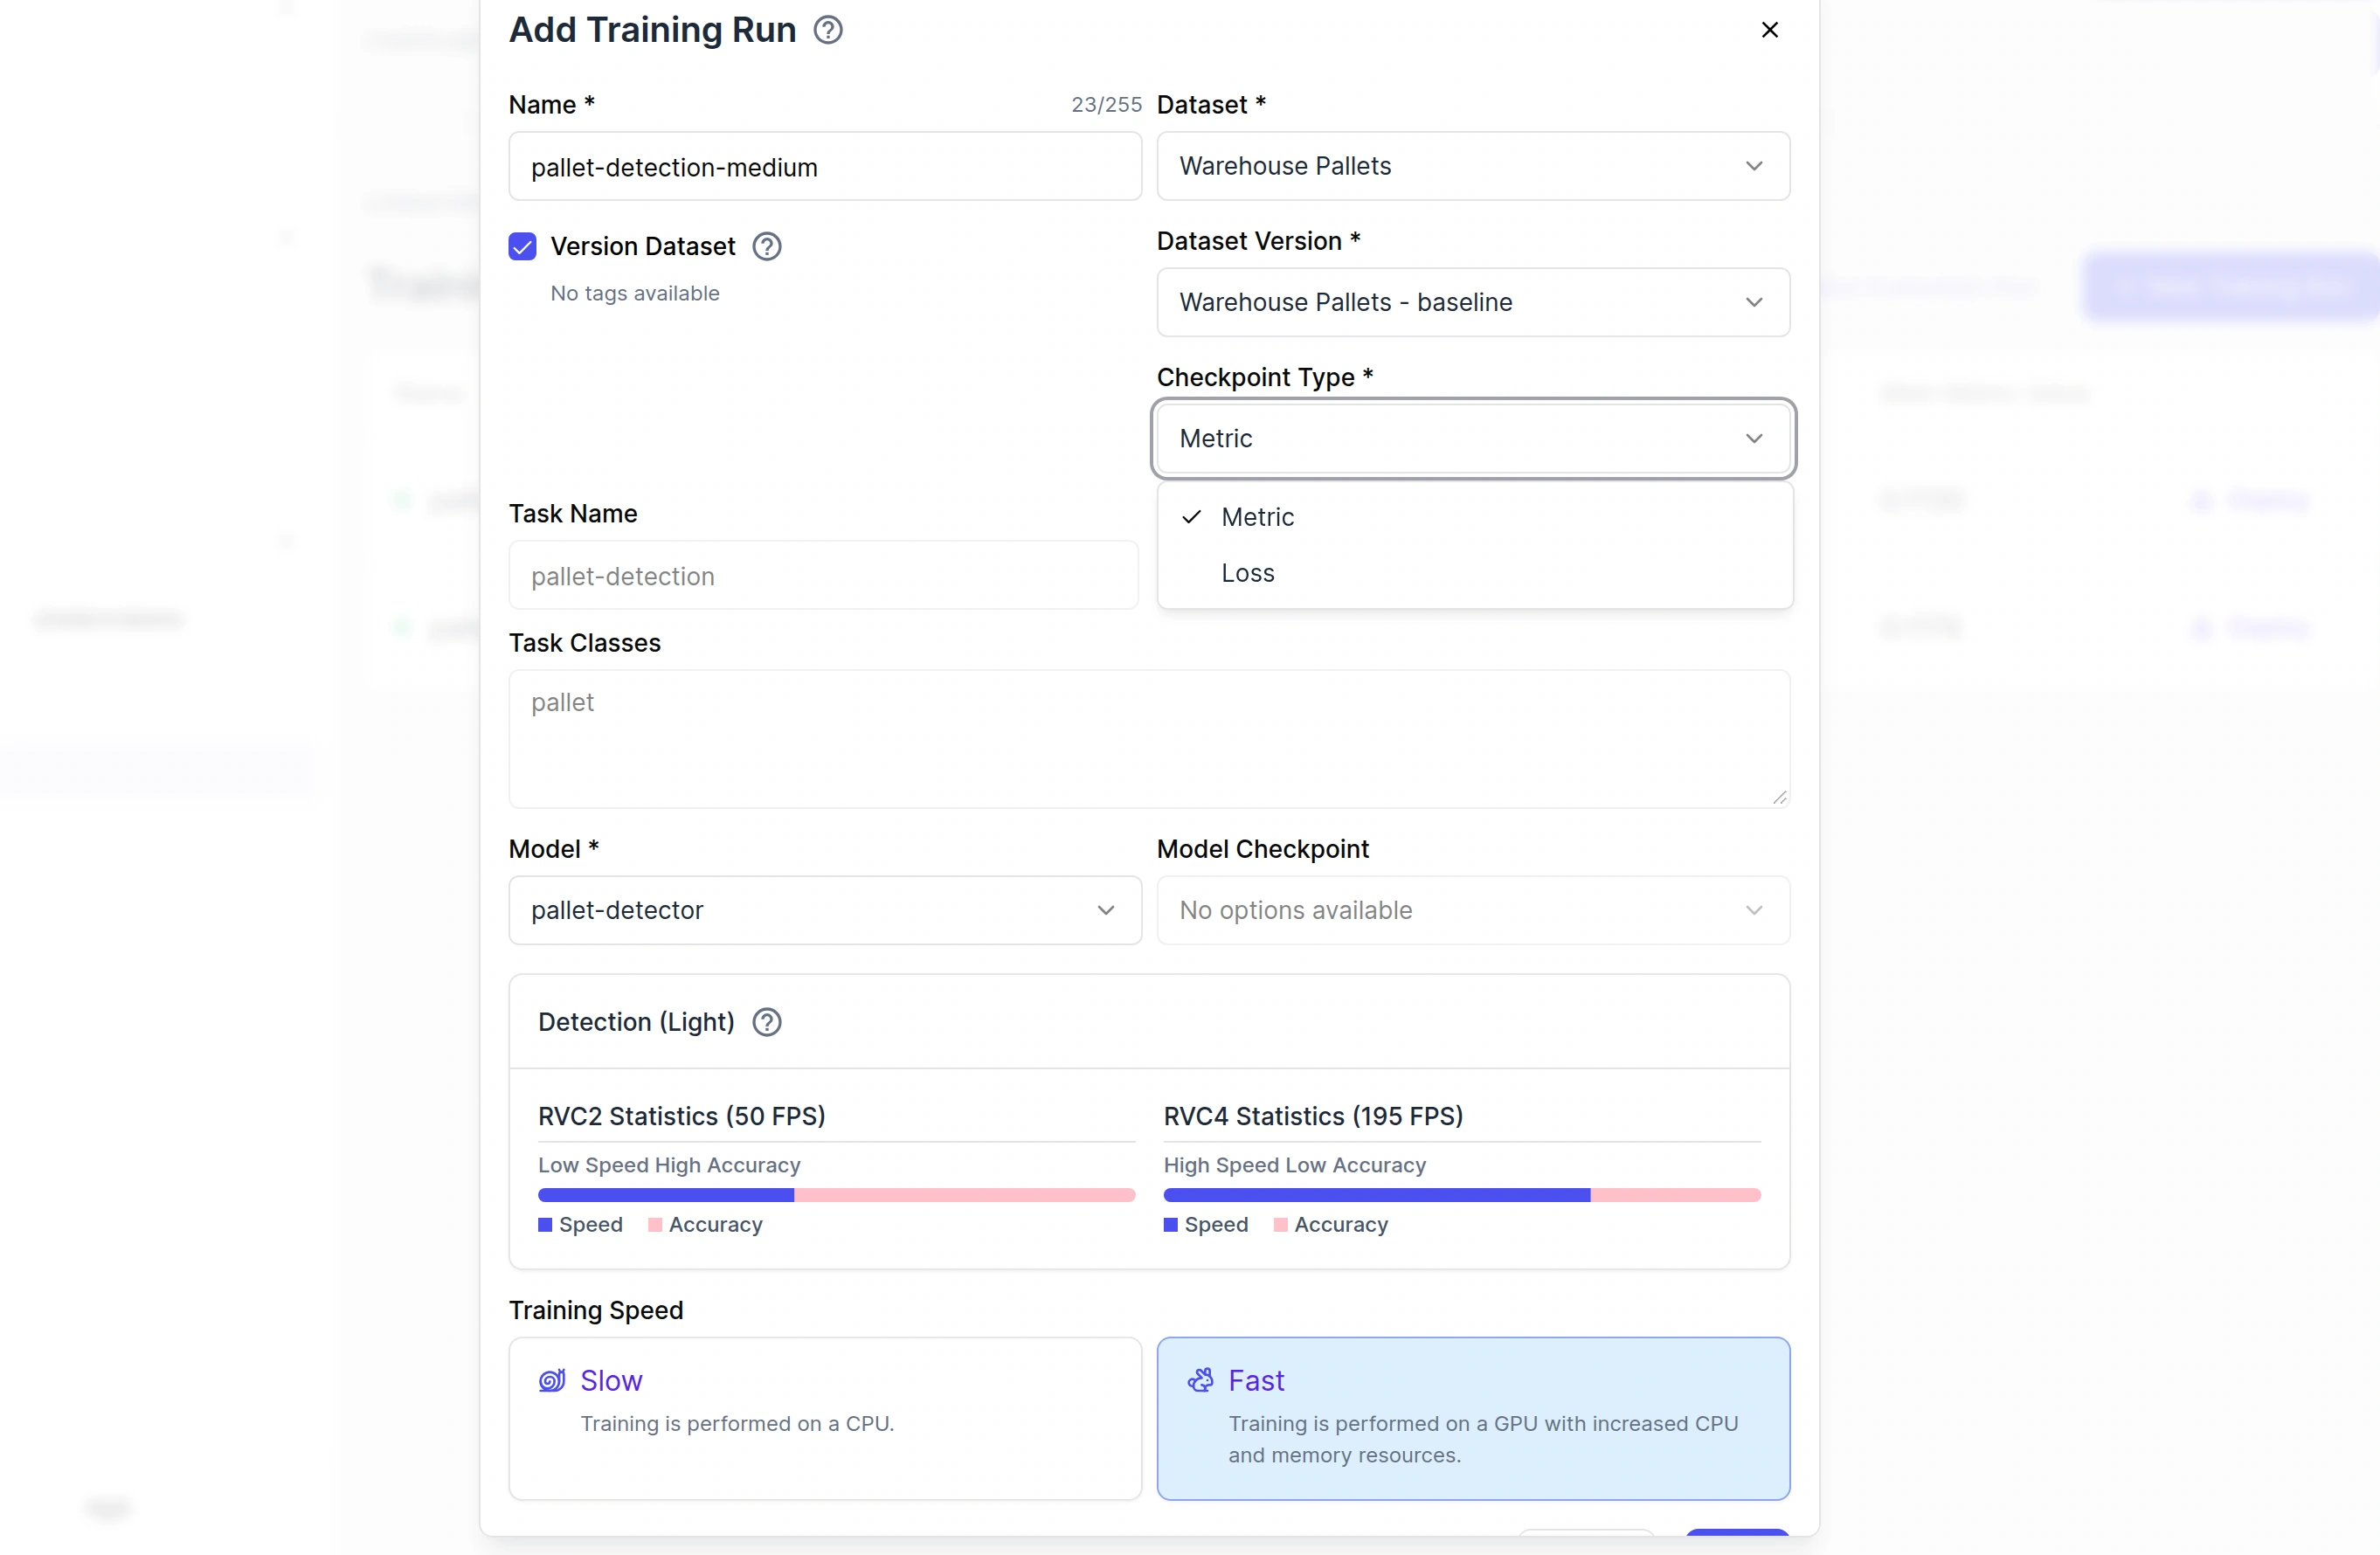
- Metric:保留任务主要指标验证值最佳的检查点。
- Loss:保留验证损失最低的检查点。
在另一个项目中重用检查点
要在新项目中继续训练,请下载第一个项目的 PyTorch 检查点并将其上传到链接到新项目的模型。您也可以通过同样的方式从本地 LuxonisTrain 训练上传检查点。兼容的检查点将在您创建运行时出现在 Model Checkpoint 下。
确认训练配置
从您的团队可用的训练速度中选择,审查所选内容的计算类型和保守的信用估算,然后点击 Add。Hub 会保留估算并排队进行版本控制和训练工作。提交后,运行摘要会记录所选速度以及链接的数据集版本、周期、批次大小和检查点设置。下面完成的示例使用了 Medium 训练速度。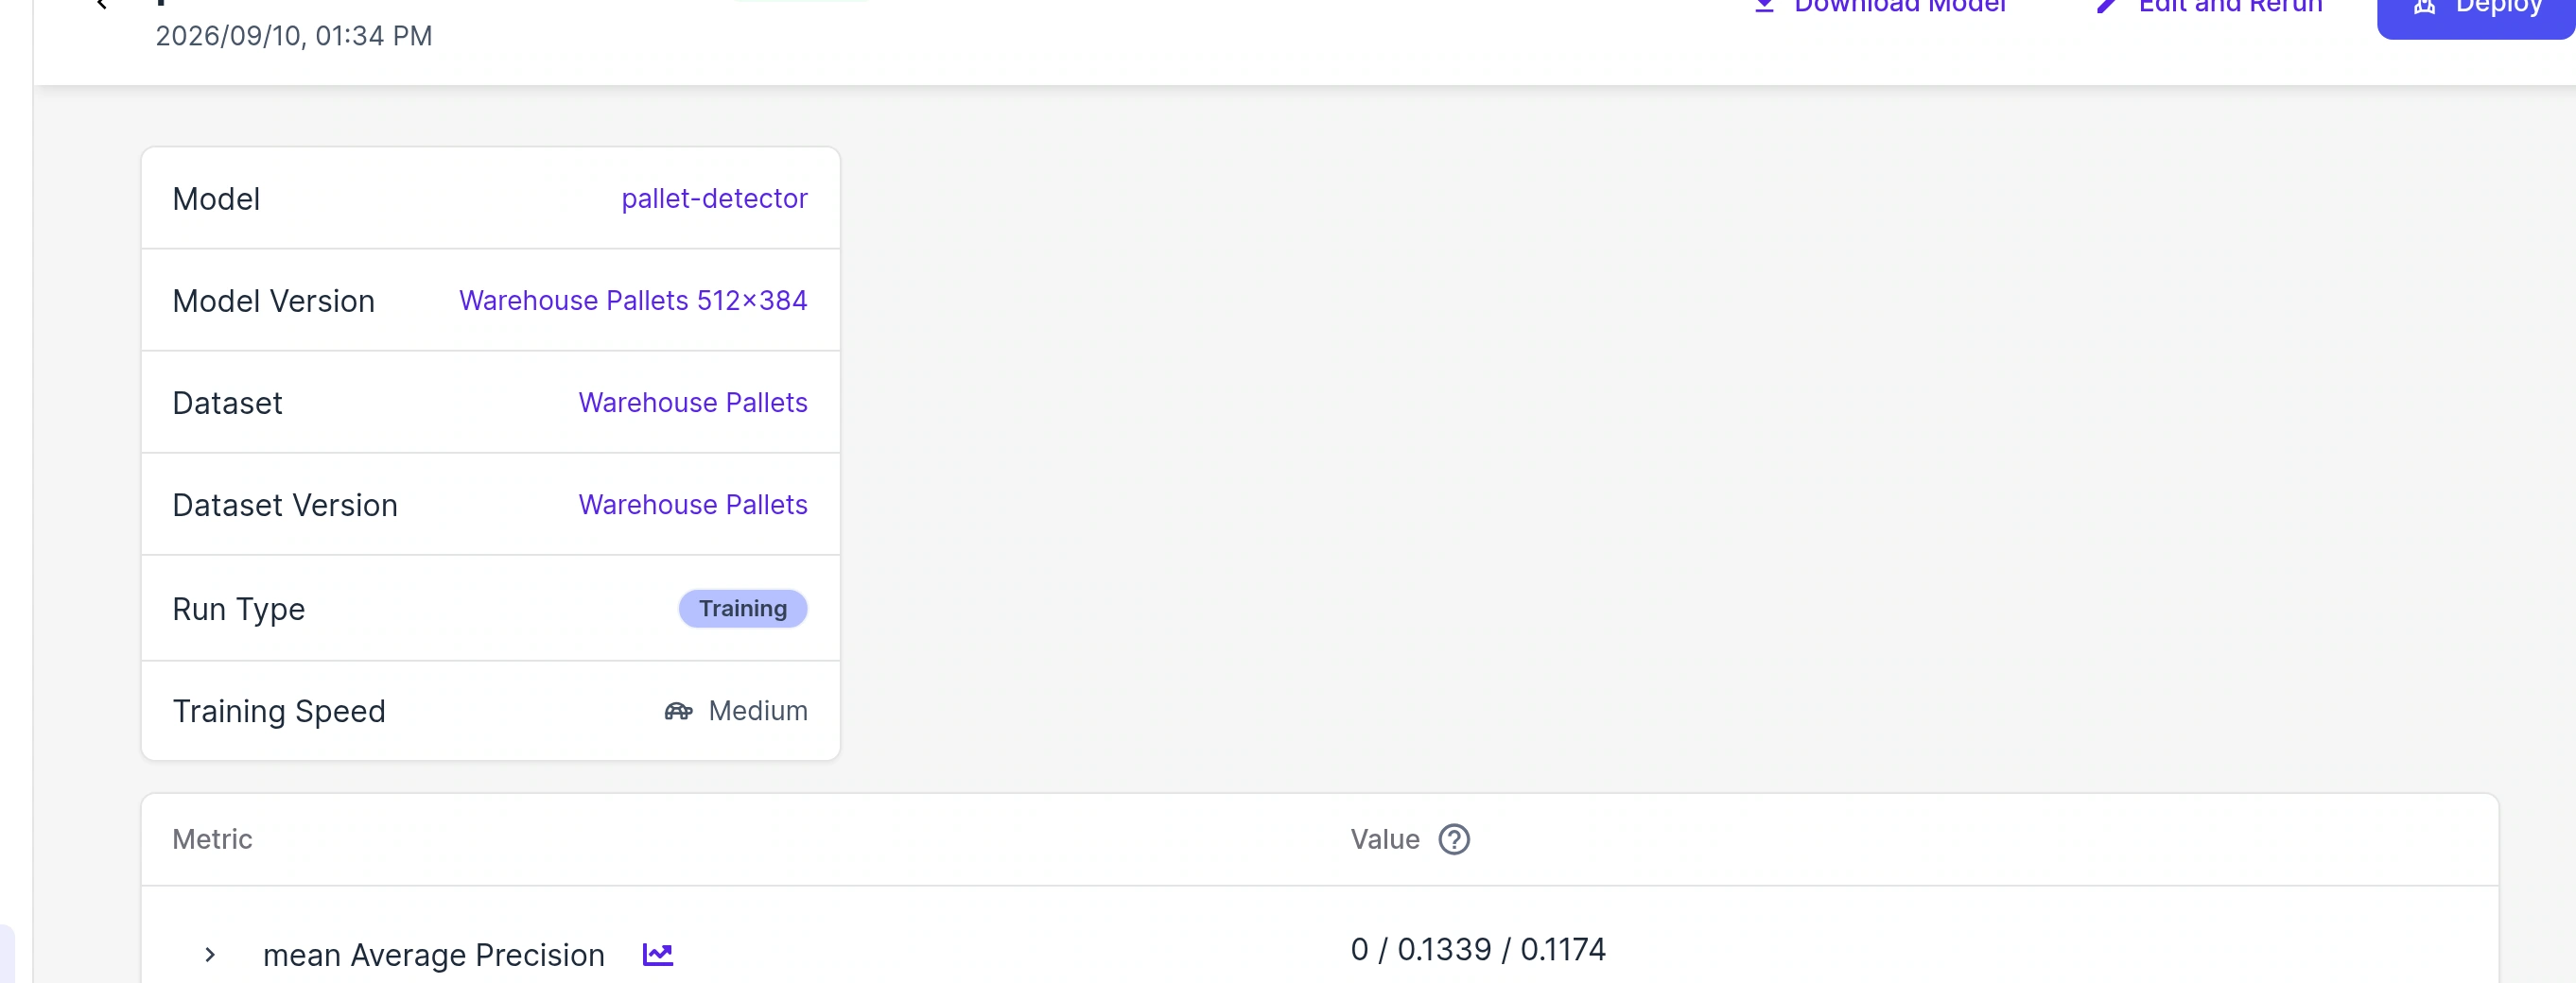
监控运行并打开其结果
运行从 Pending 进展到 Running,然后到 Completed、Failed 或 Shutdown。打开运行以检查元数据、日志、使用的信用、指标、曲线以及任何已记录的推理图像。完成的训练运行会发布链接模型的新版本,并从运行页面公开它。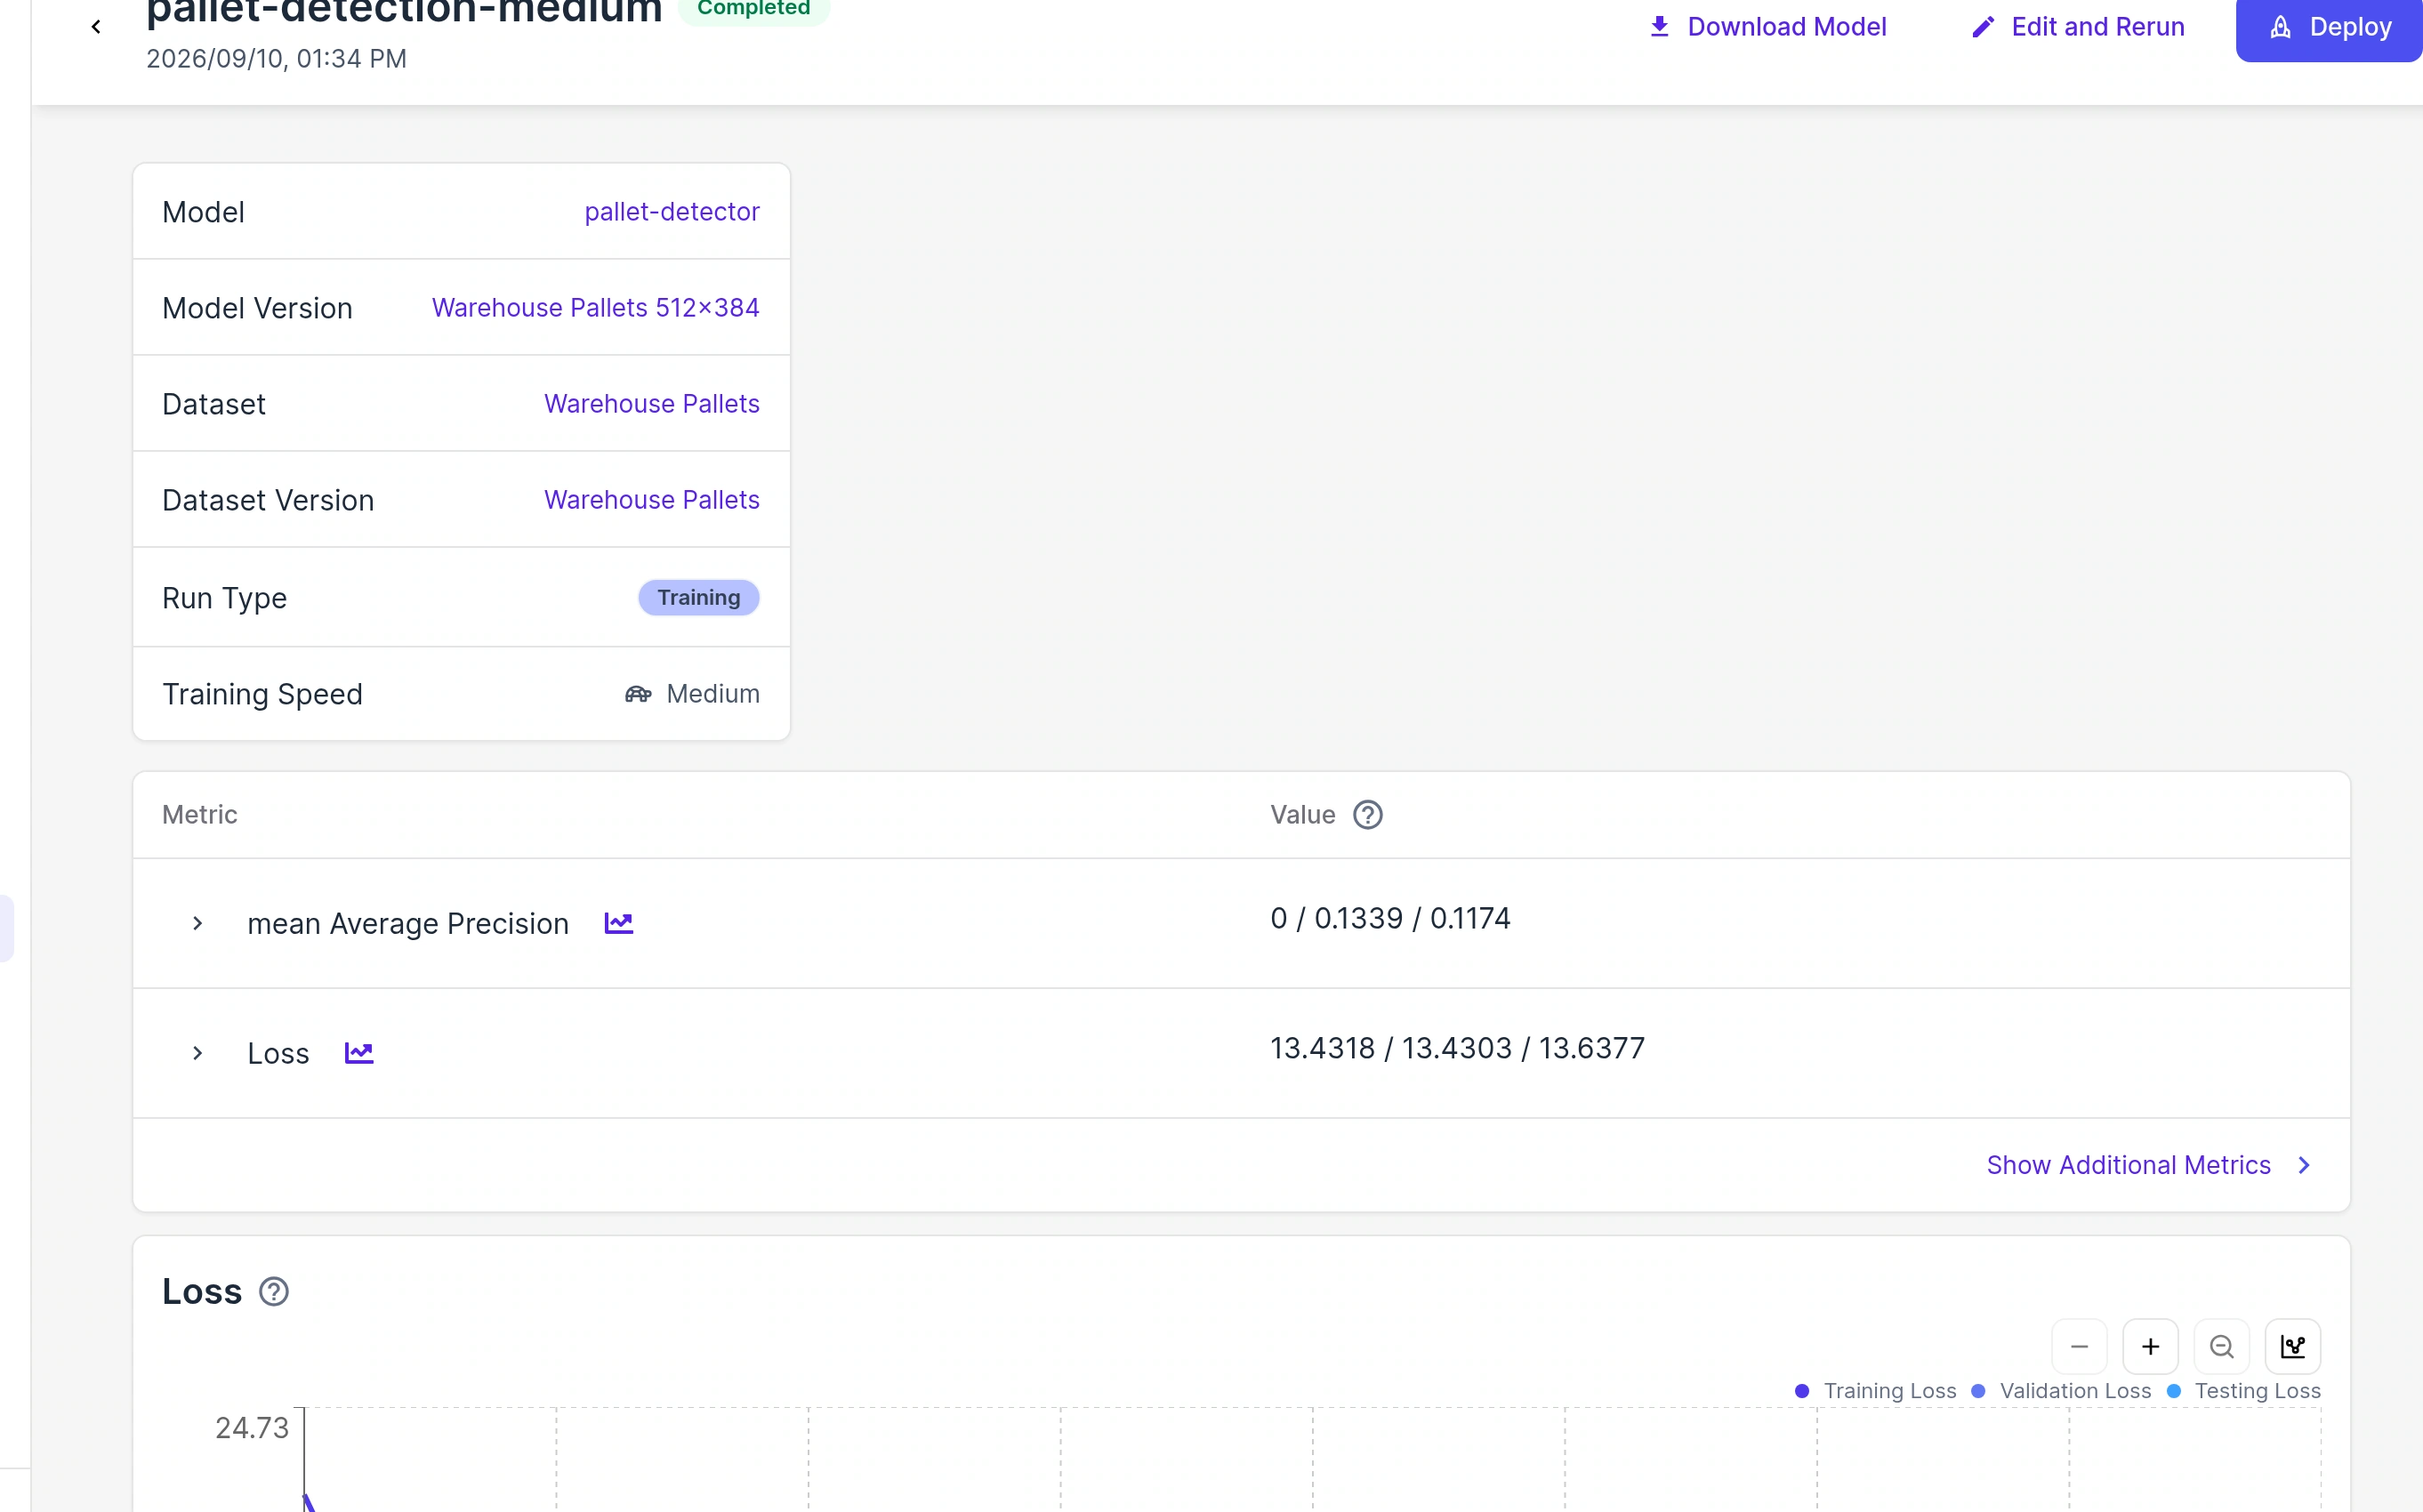
开始评估运行
打开评估运行表单
从项目中,点击 New Evaluation Run 并输入一个名称,例如 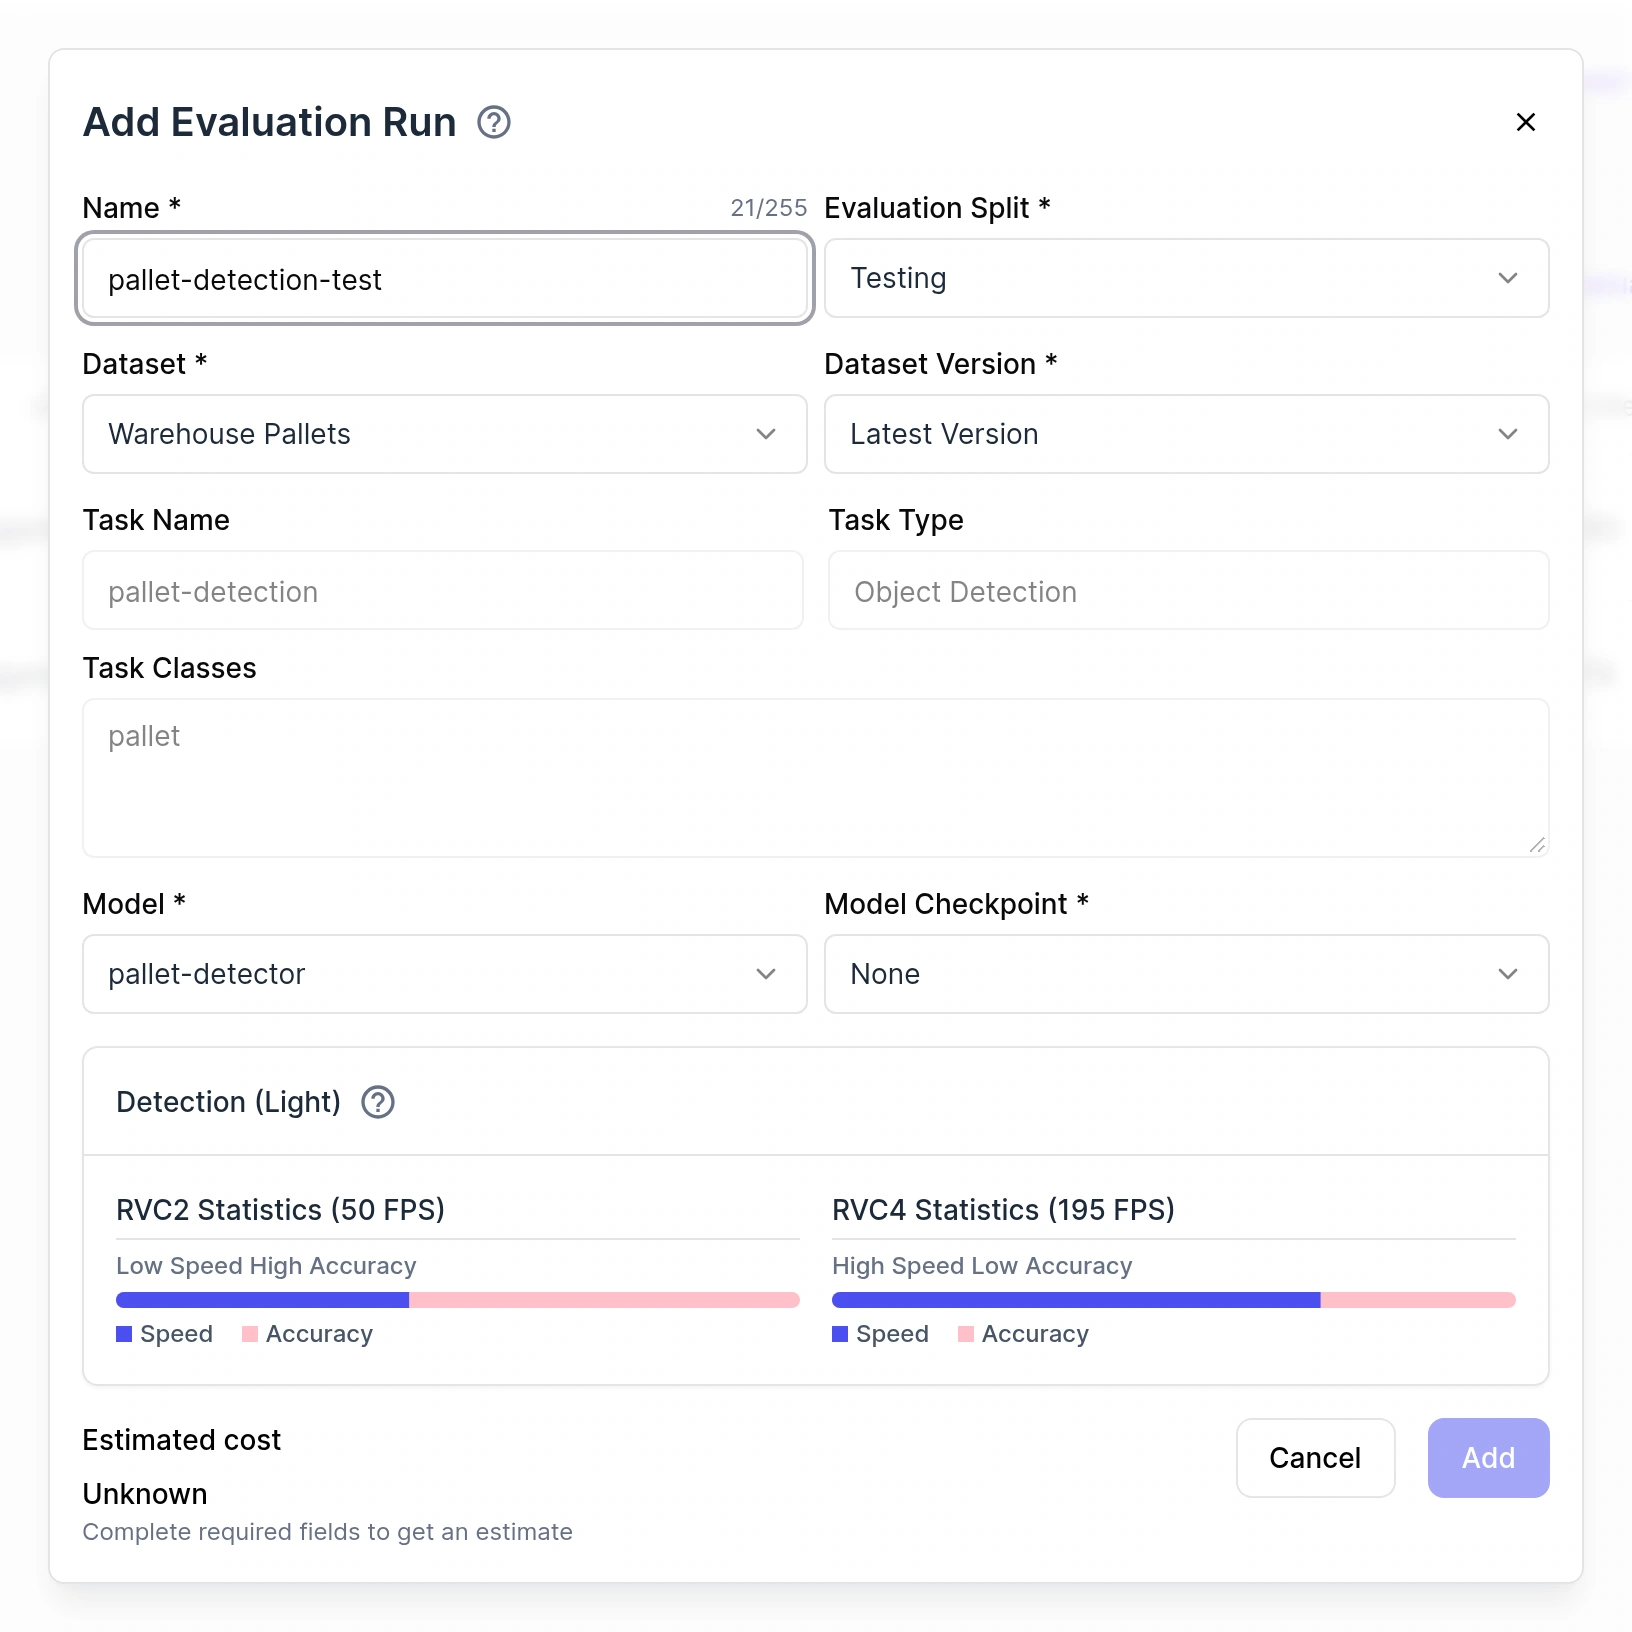
pallet-detection-test。选择评估数据
选择 Validation 或 Testing,然后选择数据集和可选的数据集版本。所选拆分必须包含已完成的样本。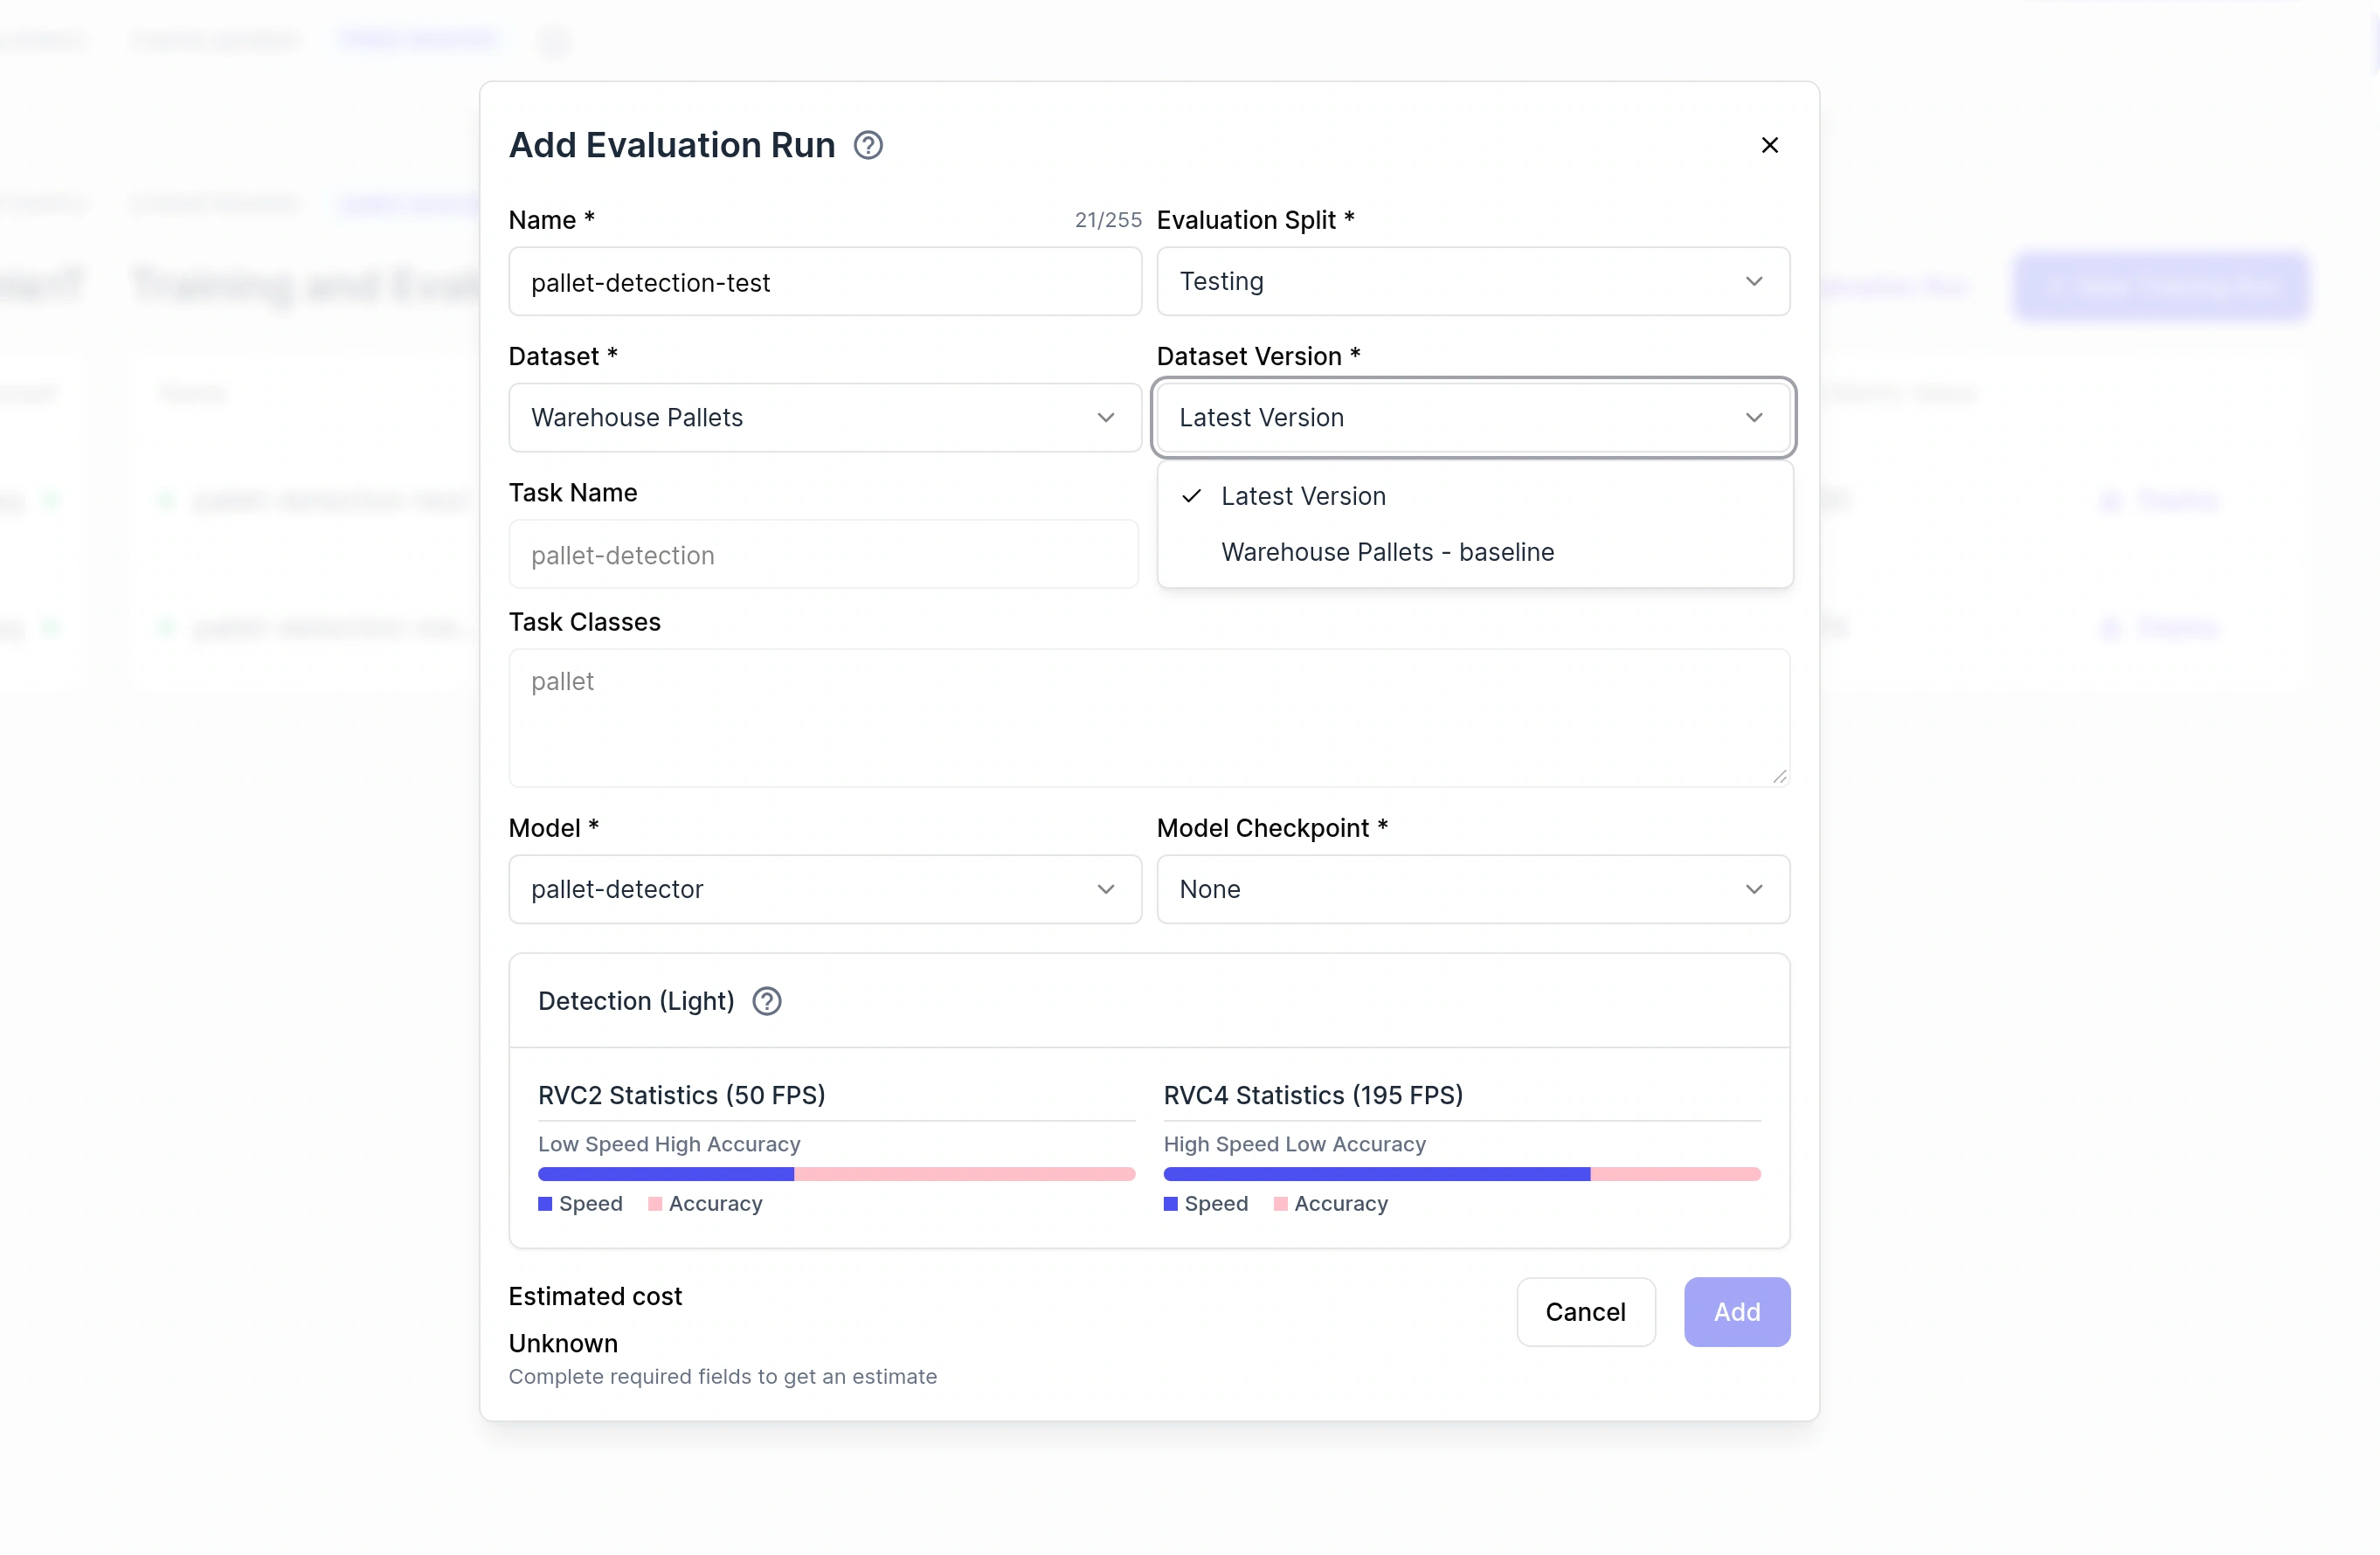
选择检查点并运行评估
选择链接的模型和所需的 Model Checkpoint,审查估计的信用,然后提交运行。完成后,打开结果以检查其指标、推理图像和日志。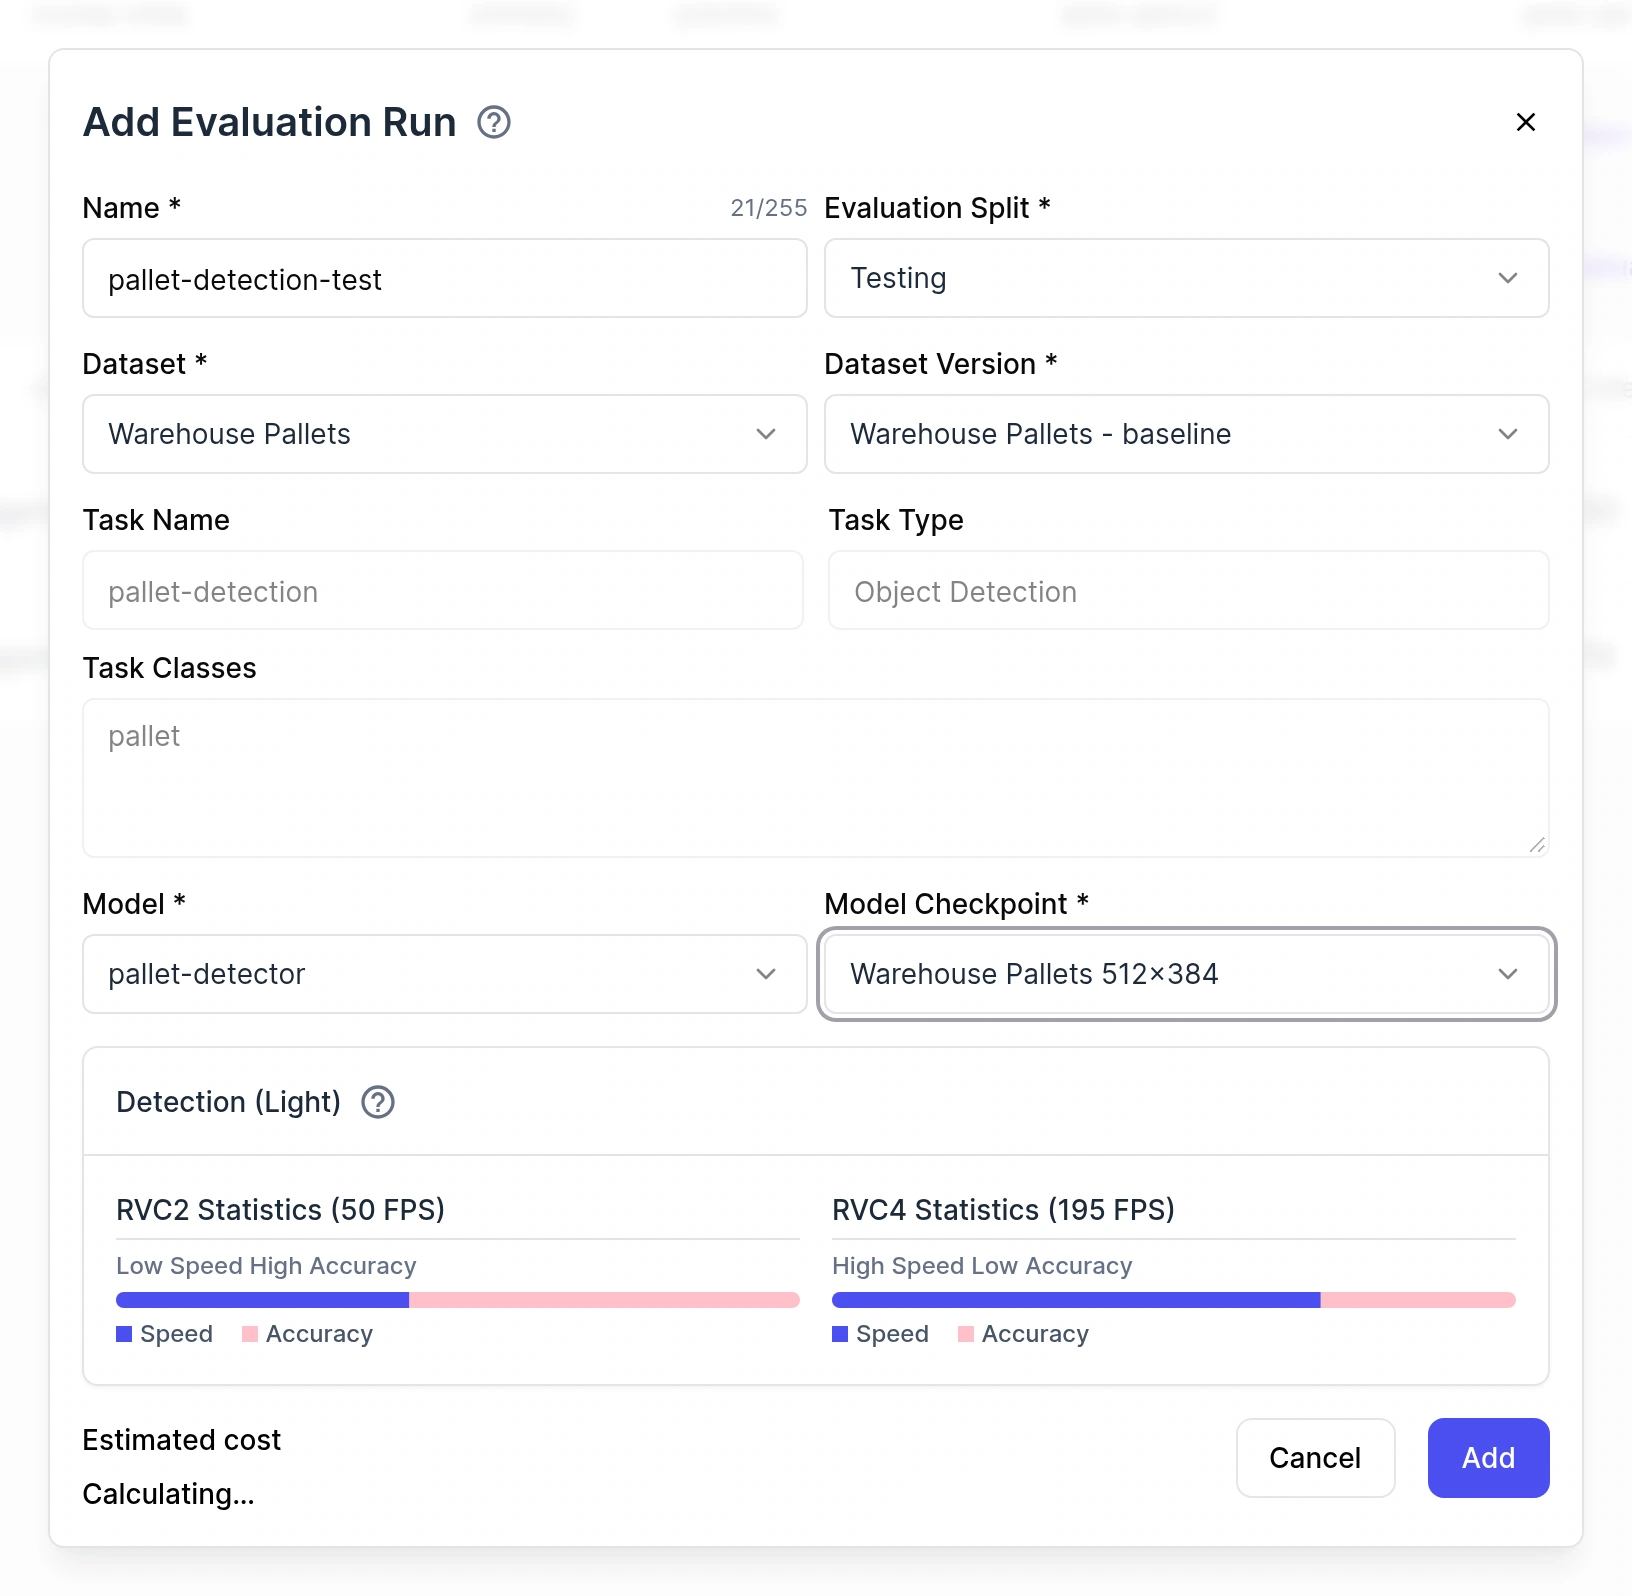
审查运行结果
仅当任务、评估拆分和数据集版本等效时才比较运行。不同数据的结果不是同类模型比较。
比较指标表
打开已完成的训练或评估运行并找到 Metrics。该表按任务对值进行分组,并显示可用的 Training、Validation 和 Testing 结果。使用 Show Additional Metrics 检查次要和每类值。项目页面还会显示每个运行的 Main Metric 以进行快速比较。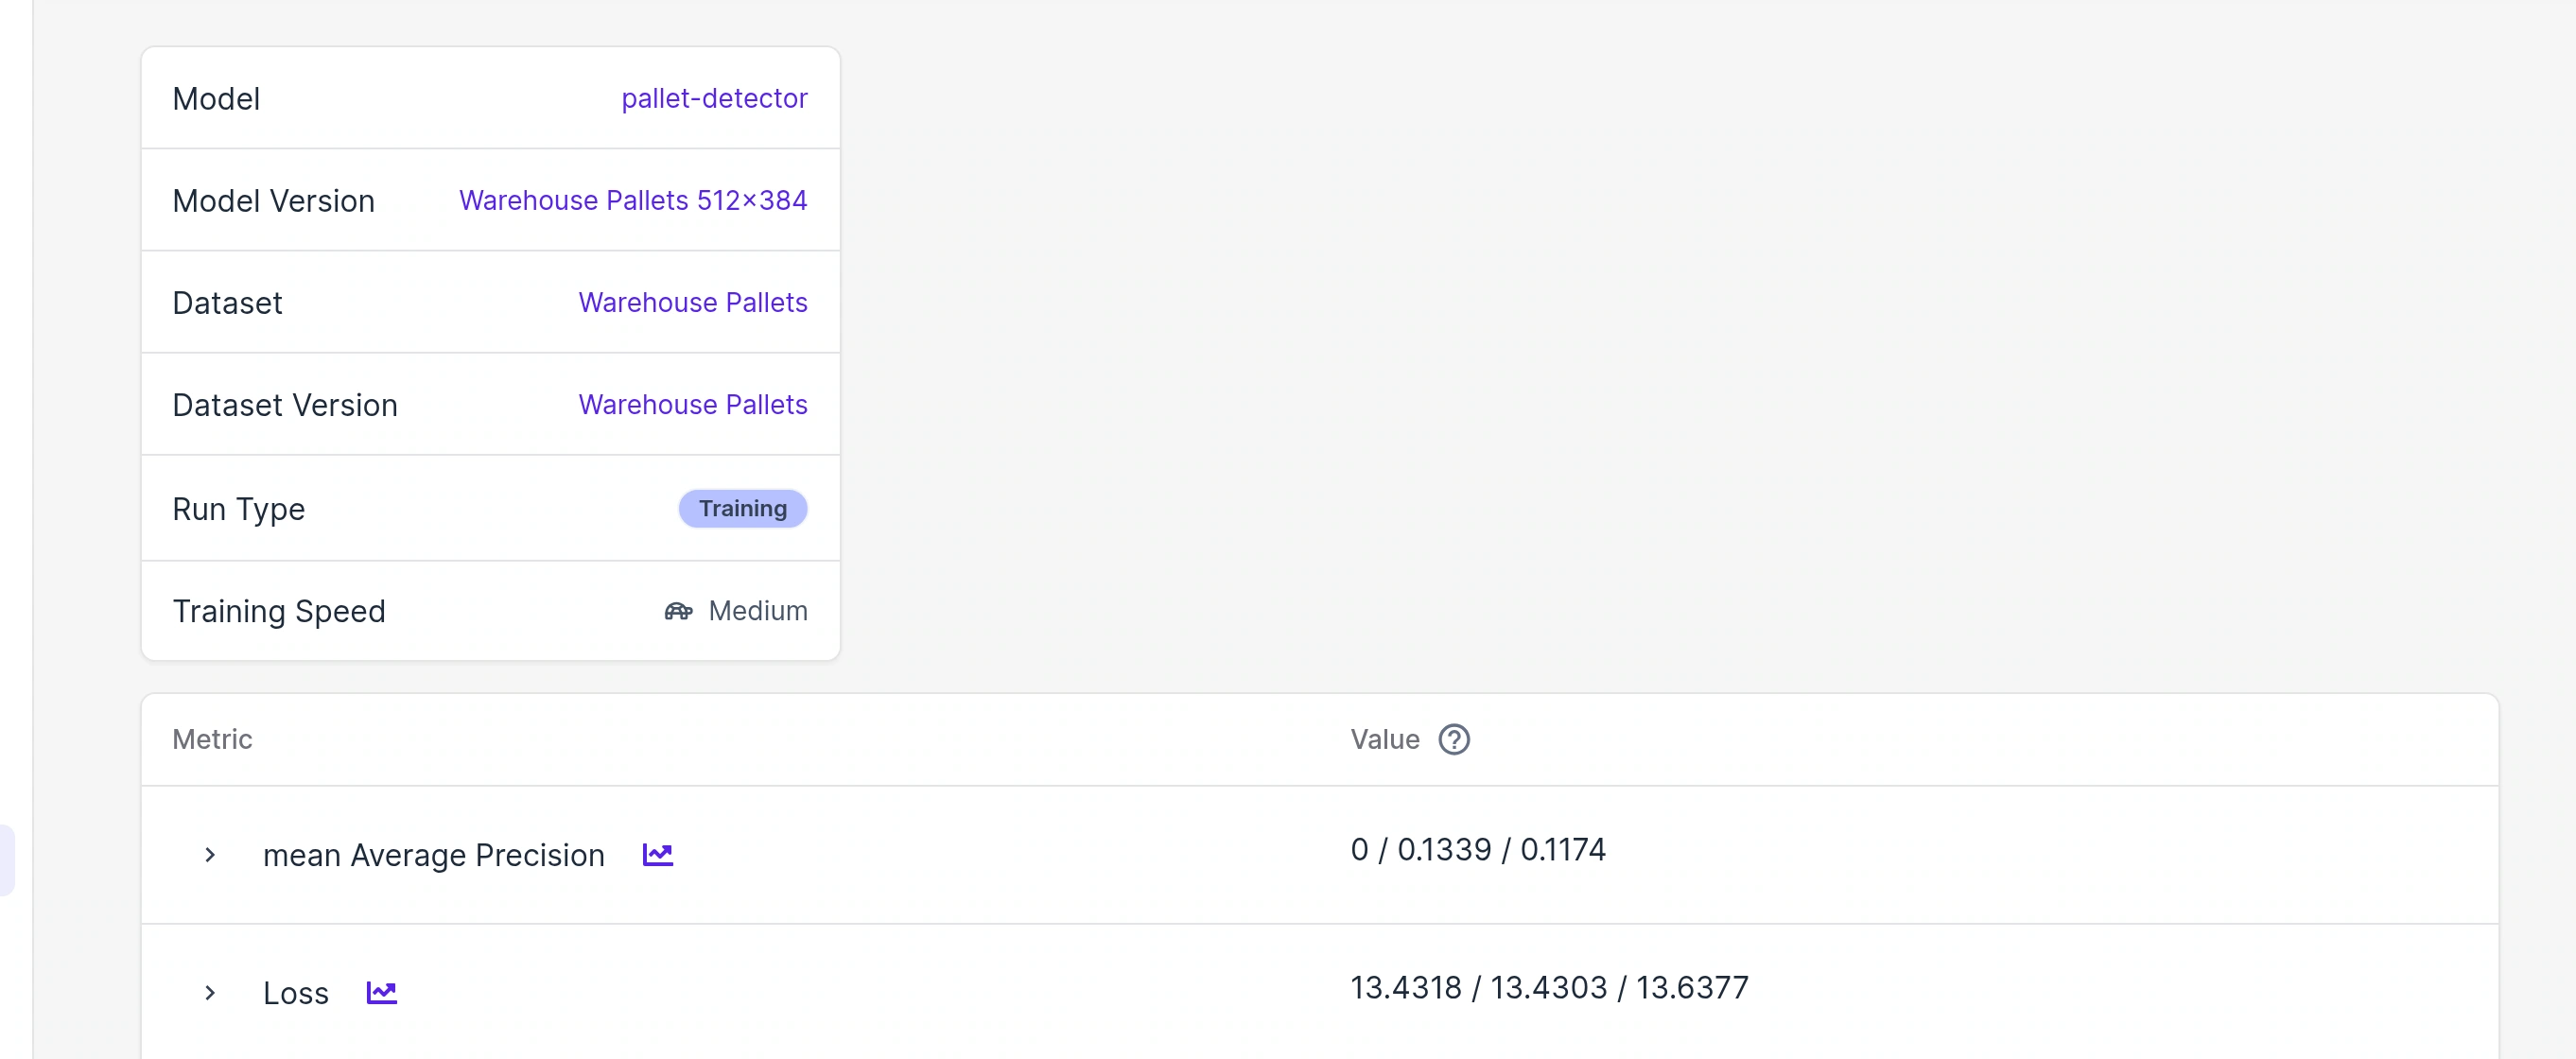
检查损失和指标曲线
在训练运行中,比较跨周期的训练和验证曲线。损失越低越好。对于主要指标,通常越高越好;当两条曲线都在没有持续差距的情况下改进时,模型正在学习和泛化。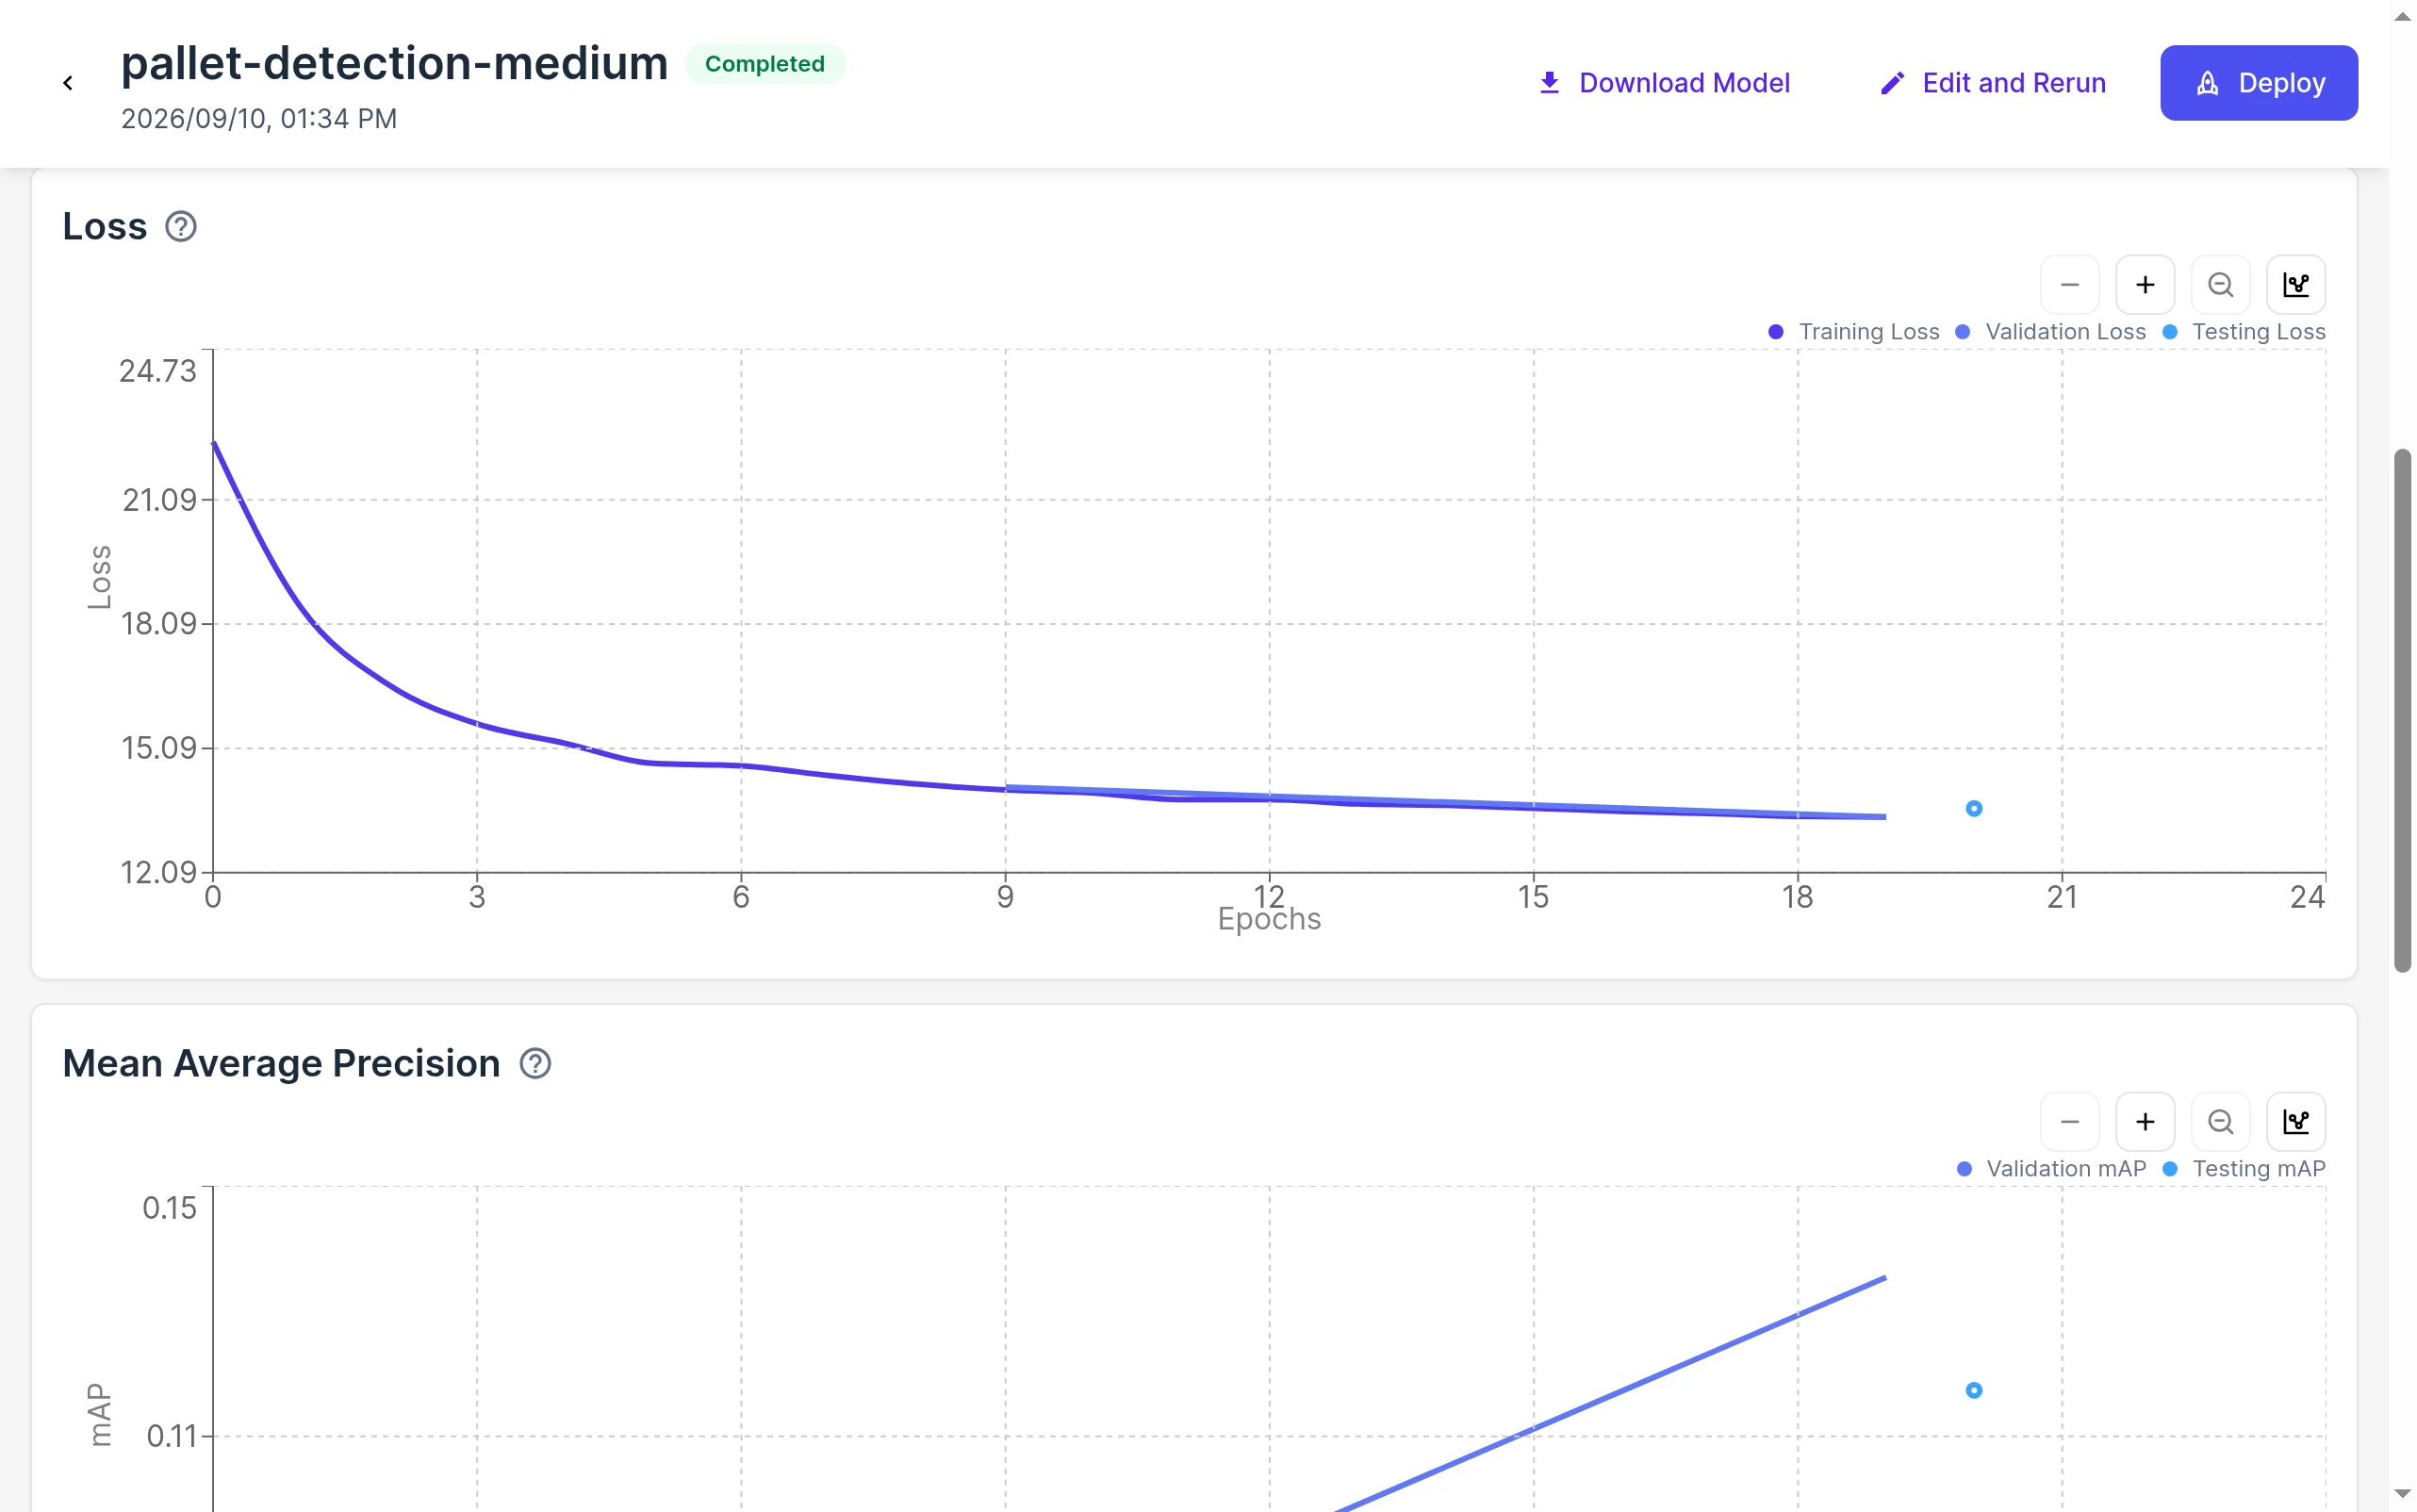
审查跨周期的推理图像
使用 Inference Images 周期控制来比较训练期间的预测。真实值与模型预测一起显示,因此您可以发现遗漏的对象、不正确的类别、松散的定位或摘要指标可能隐藏的系统性标签问题。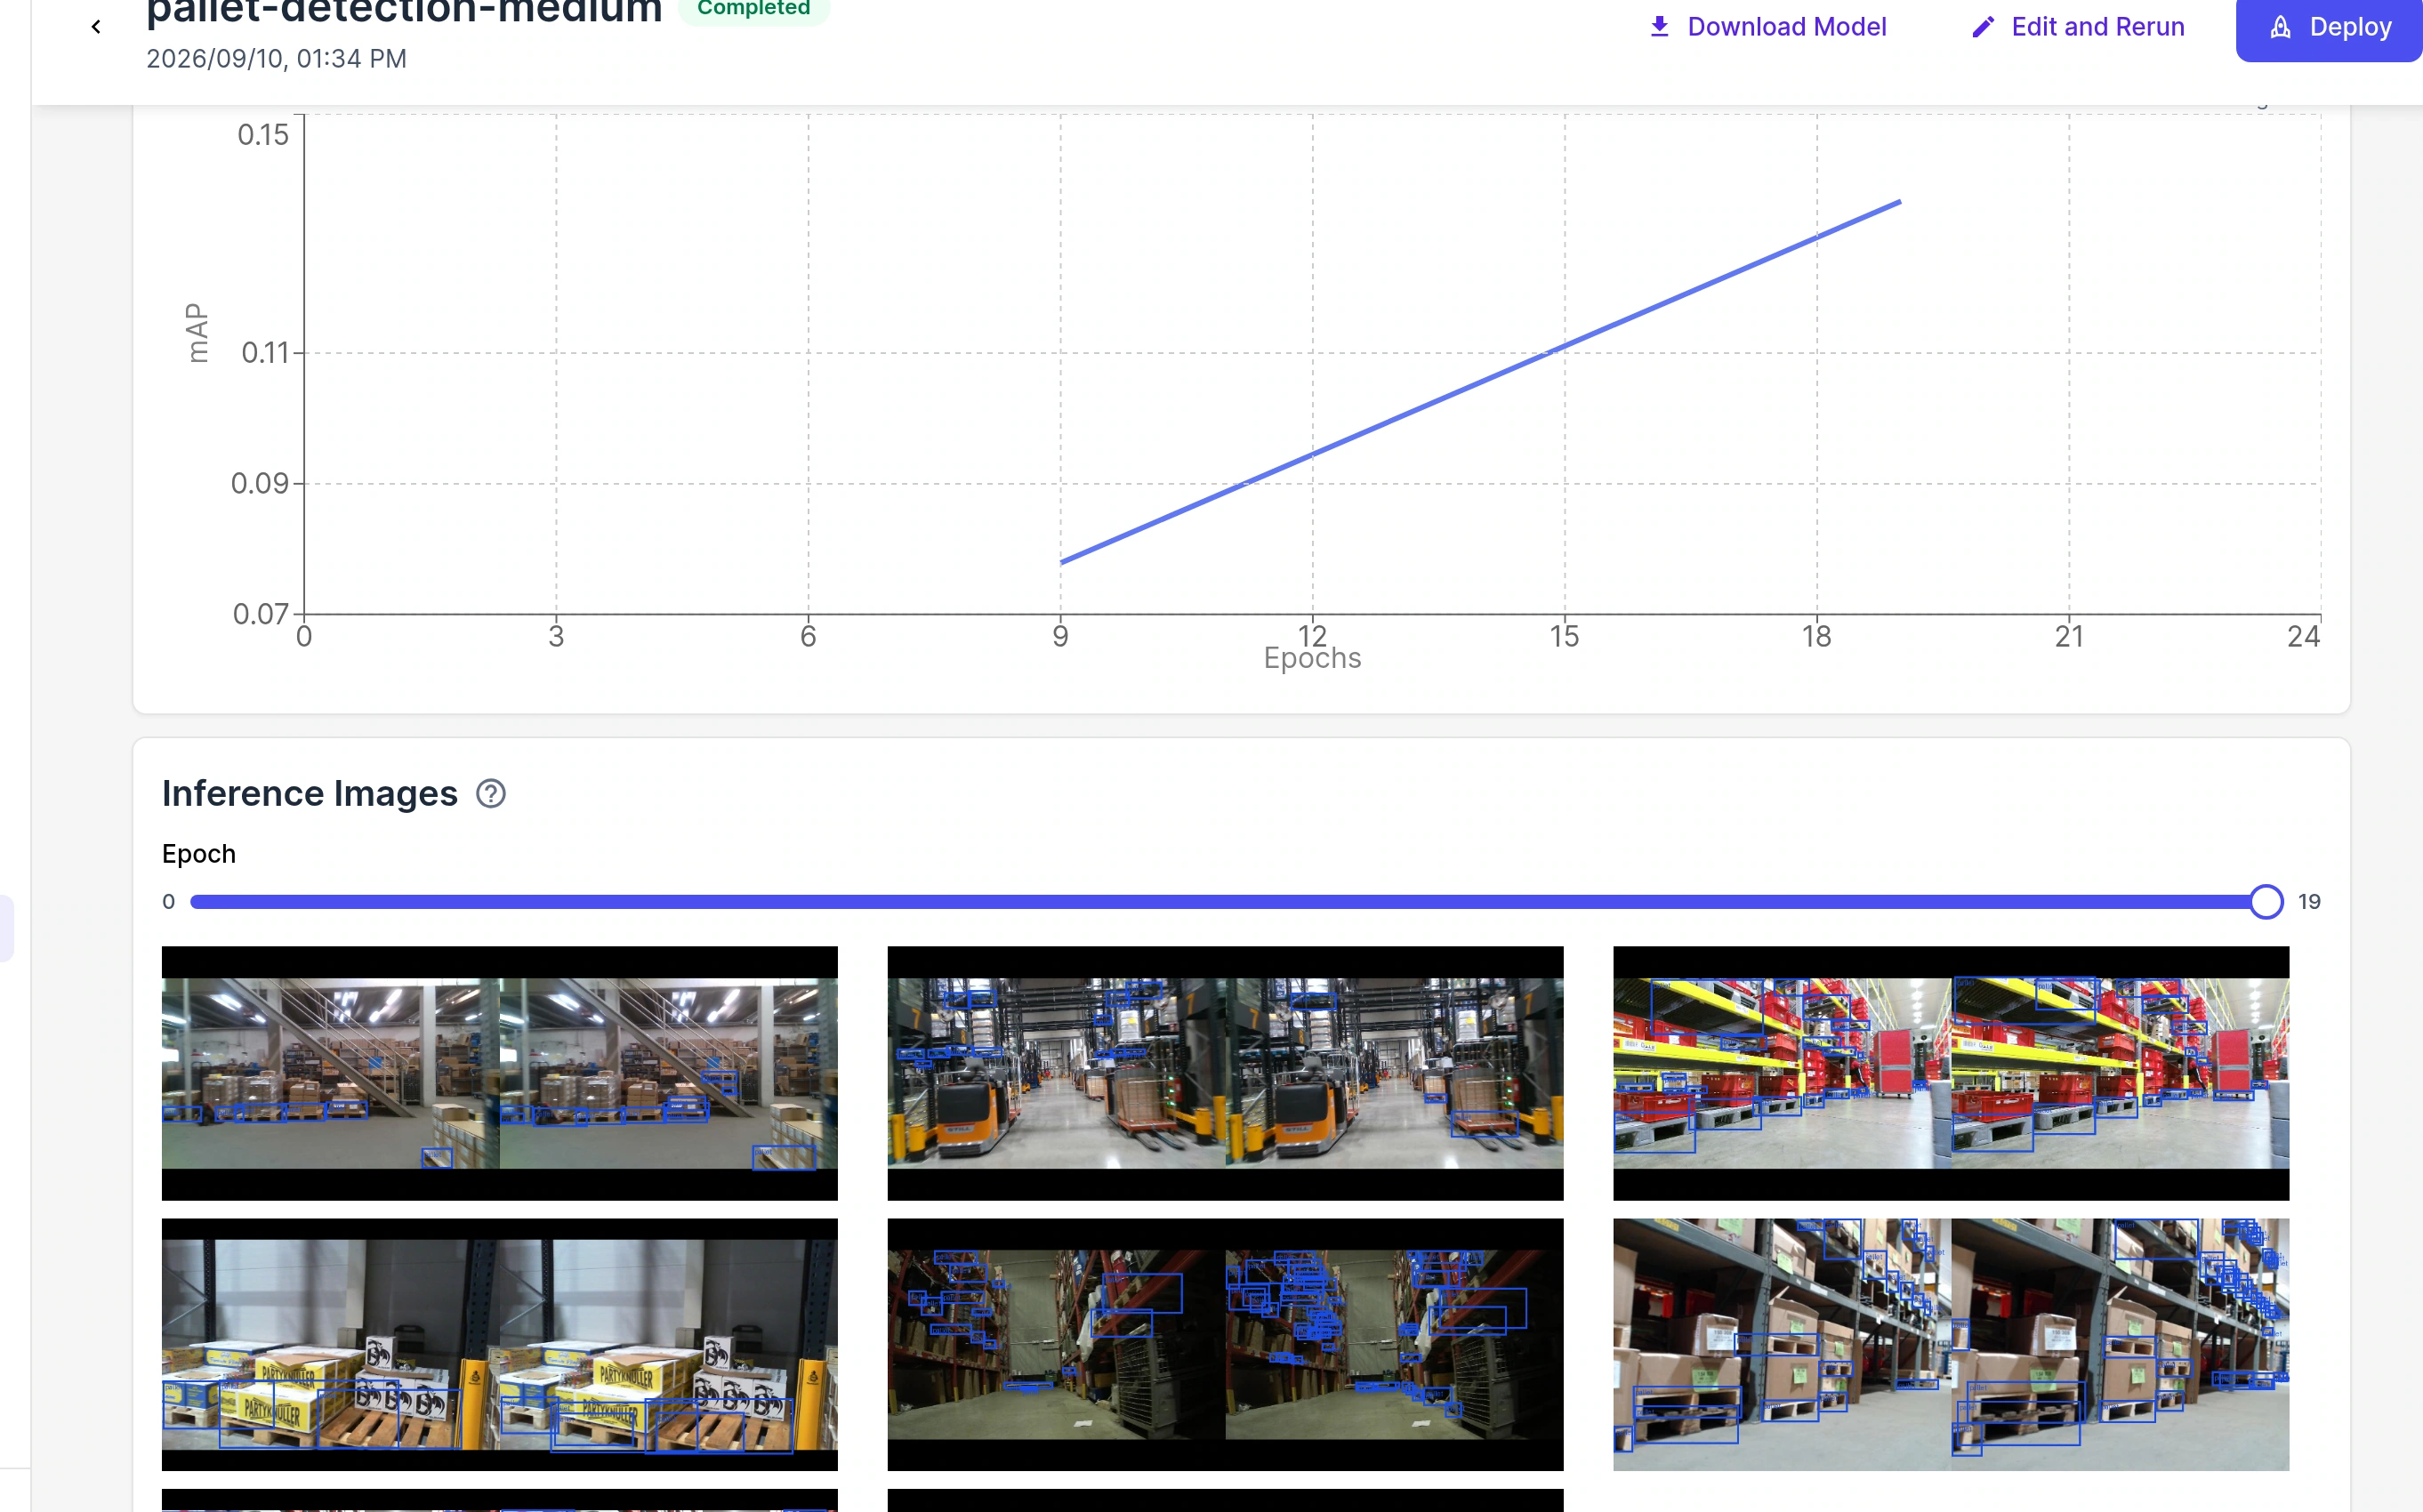
主要指标
| 任务 | 主要指标 | 总结内容 |
|---|---|---|
| 分类 | F1 分数 | 精确度和召回率之间的平衡 |
| 对象检测 | 平均精度 (mAP) | 跨置信度和重叠阈值的检测质量 |
| 语义分割 | Jaccard 指数 | 预测掩码和真实掩码之间的重叠 |
| 实例分割 | 平均精度 (mAP) | 实例检测和掩码质量 |
| 关键点检测 | 平均精度关键点 | 跨示例的关键点定位质量 |
| OCR | OCR 准确率 | 识别文本的正确性 |
附加指标
mAP50和mAP75,它们在不同的交并比阈值下评估检测;- 精确度和召回率,它们揭示了假阳性和漏报之间的权衡;
- 每类结果,它们揭示了被聚合隐藏的弱类;
- 分割重叠度量,例如平均交并比和 Dice;
- 基于对象关键点相似度的关键点指标;
- 任务特定的准确率或召回率值。
识别常见的曲线模式
| 模式 | 可能的解释 | 下一步行动 |
|---|---|---|
| 训练和验证损失一起下降;两个主要指标都上升 | 学习正在进行,泛化稳定 | 在保留的测试数据上评估选定的检查点 |
| 训练改进,而验证停滞或下降 | 过拟合训练拆分 | 添加多样化数据,改进拆分或增强,或提前停止 |
| 两个损失都保持高位,指标保持低位 | 欠拟合、训练不足或任务/数据不匹配 | 检查注释、架构容量、配置和运行持续时间 |
| 某个类别比聚合结果弱得多 | 类别不平衡、标签不一致或更难的示例 | 检查每类数据并收集或纠正代表性样本 |
| 指标看起来不错,但预测明显错误 | 数据泄露、不合适的指标或注释质量问题 | 在推广模型之前审计拆分和真实值 |
选择用于部署的模型
candidate 或 production,以便应用程序和队友可以识别选定的工件。标签可以在模型内的版本之间移动,这支持稳定的推广标签,同时保留不可变的版本历史记录。继续 Hub AI 工作流 以将模型选择连接到部署和下一个数据周期。运行控制和输出
| 操作 | 结果 |
|---|---|
| Stop Training Run | 停止活动计算并将运行更改为关机;保留迄今为止生成的最佳检查点 |
| Edit and Rerun | 打开一个从选定运行填充的新运行表单,以便您从与之前运行相同的参数开始,同时调整实验 |
| Download Model | 下载运行生成的模型工件 |
| Deploy | 打开生成的模型版本的转换工作流,用于目标 RVC 平台 |
| Resume from checkpoint | 在新的训练运行中选择运行的 PyTorch 检查点作为 Model Checkpoint |
训练生成两个模型实例
成功的训练运行会创建一个模型版本,其中包含用于推理的 ONNX NN Archive 和用于恢复训练、评估和模型预注释的 PyTorch 检查点。评估运行仅记录结果。有关模型层次结构,请参阅 模型注册表概念。